रसीद पार्सिंग कैसे काम करती है: Yomio के OCR पाइपलाइन के अंदर (AWS + Azure)
Yomio की रसीद OCR पाइपलाइन में एक तकनीकी गहराई से गोता — कैसे AWS Textract और Azure Document Intelligence बड़े पैमाने पर रसीद डेटा निकालते, सामान्यीकृत और वर्गीकृत करते हैं।

Alex Chen
उत्पाद प्रबंधक और व्यक्तिगत वित्त अधिवक्ता
रसीद पार्सिंग कैसे काम करती है: Yomio के OCR पाइपलाइन के अंदर (AWS + Azure)
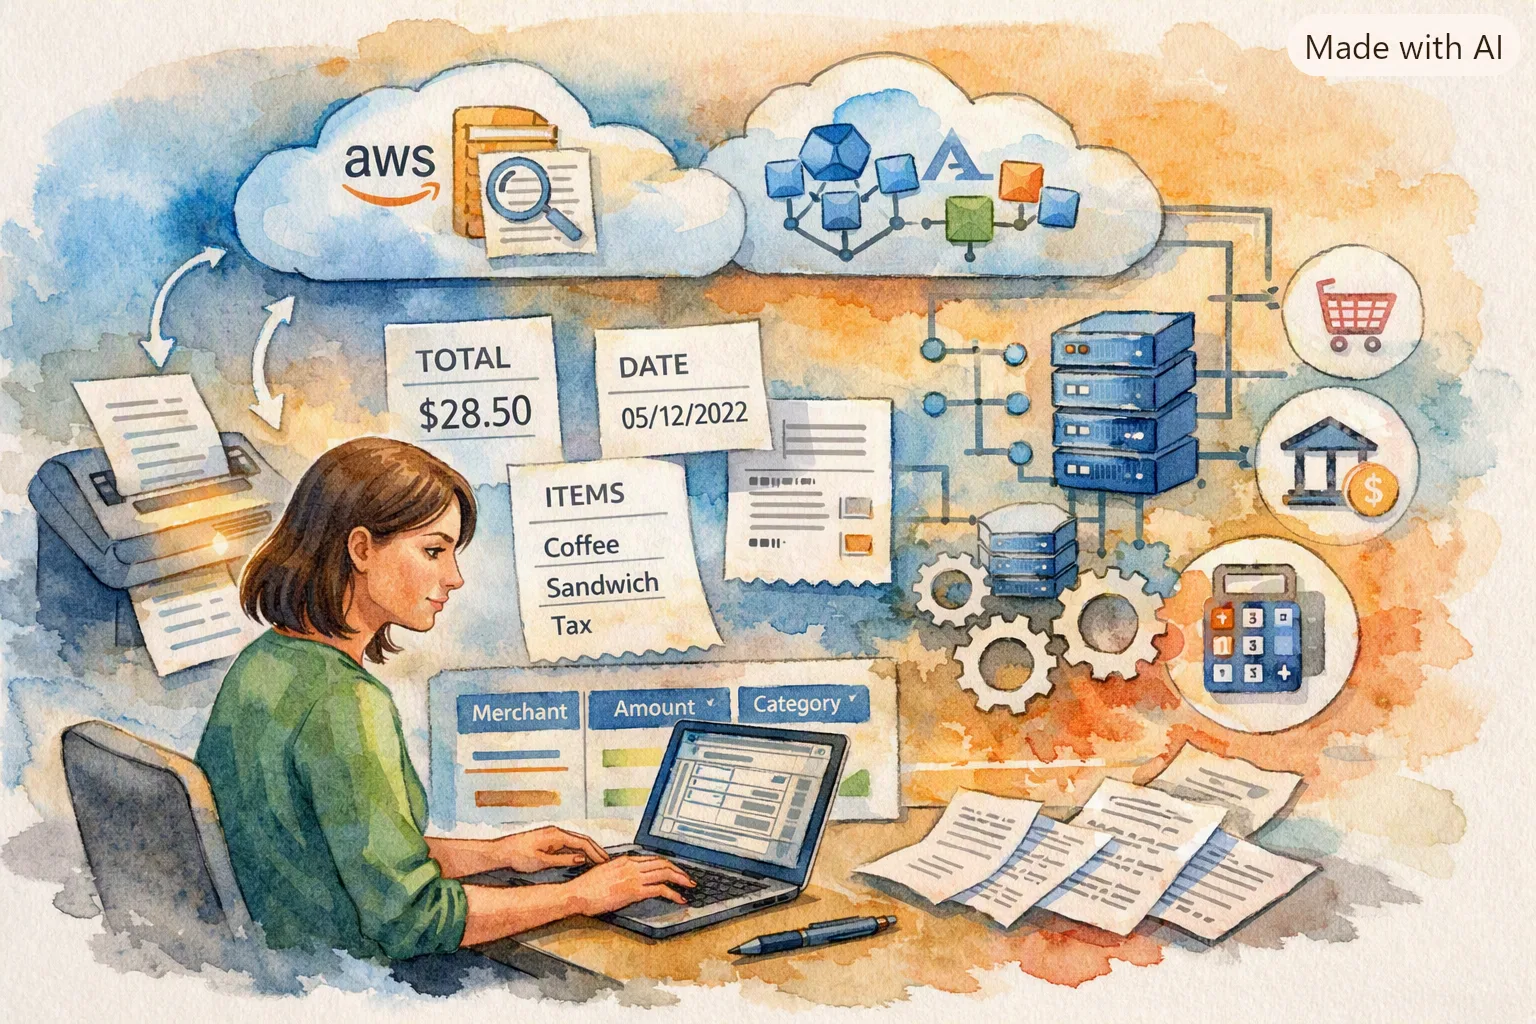
जब आप Yomio में एक रसीद स्कैन करते हैं, तो शटर बटन दबाने और अपने डैशबोर्ड में वर्गीकृत लेन-देन देखने के बीच बहुत कुछ होता है। आपकी रसीद फोटो एक बहु-चरणीय OCR पाइपलाइन से गुज़रती है जो कच्चे टेक्स्ट को संरचित वित्तीय डेटा में निकालती, सामान्यीकृत और समृद्ध करती है।
यह लेख बताता है कि उस पाइपलाइन के अंदर क्या होता है। यह तकनीकी है — लेकिन यह समझने के लिए भी उपयोगी है कि कुछ रसीदें पूरी तरह से स्कैन क्यों होती हैं और अन्य को सुधार की आवश्यकता क्यों होती है, और हम उस अंतर को कम करने के लिए कैसे काम कर रहे हैं।
मुख्य बातें
- Yomio AWS Textract और Azure Document Intelligence दोनों का उपयोग करता है — अतिरेक और सटीकता के लिए दोहरे-प्रदाता आर्किटेक्चर
- पाइपलाइन में 5 चरण हैं: अंतर्ग्रहण, OCR निष्कर्षण, सामान्यीकरण, वर्गीकरण, संवर्धन
- लाइन-आइटम निष्कर्षण सबसे कठिन समस्या है — रसीदों का कोई मानक प्रारूप नहीं है
- विश्वास स्कोरिंग मानव समीक्षा के लिए कम-विश्वास वाले क्षेत्रों को चिह्नित करता है
- मल्टी-मोडल समर्थन — चित्र, PDF और संरचित डेटा प्राप्त करता है
- वर्तमान सटीकता: 94.7% लाइन-आइटम निष्कर्षण, 99.3% कुल कैप्चर
- प्रसंस्करण समय: स्कैन से वर्गीकृत प्रविष्टि तक प्रति रसीद 2–6 सेकंड
पाइपलाइन अवलोकन
OCR पाइपलाइन के पाँच चरण हैं:
- अंतर्ग्रहण — छवि पूर्व-प्रसंस्करण और प्रारूप सत्यापन
- OCR निष्कर्षण — AWS Textract / Azure Document Intelligence के माध्यम से टेक्स्ट और संरचना निष्कर्षण
- सामान्यीकरण — व्यापारी नाम मिलान, दिनांक स्वरूपण, मुद्रा पहचान
- वर्गीकरण — लाइन-आइटम और कुल-स्तरीय श्रेणी असाइनमेंट
- संवर्धन — बारकोड खोज, उत्पाद डेटा, उपयोगकर्ता खाता लिंकिंग
प्रत्येक चरण में अंतर्निहित फ़ॉलबैक हैं। यदि कोई चरण कम-विश्वास वाला आउटपुट उत्पन्न करता है, तो पाइपलाइन खराब डेटा को आगे बढ़ाने के बजाय उसे चिह्नित करती है।
चरण 1: अंतर्ग्रहण — छवि पूर्व-प्रसंस्करण
OCR इंजन के रसीद को छूने से पहले, छवि पूर्व-प्रसंस्करण से गुज़रती है:
प्रारूप सामान्यीकरण:
- फ़ोटो को सबसे लंबे किनारे पर अधिकतम 2048px तक आकार दिया जाता है
- भंडारण दक्षता के लिए JPEG संपीड़न (गुणवत्ता 85%) लागू किया जाता है
- PDF पृष्ठ 300 DPI पर छवियों में रेंडर किए जाते हैं
गुणवत्ता जाँच:
- धुंधला पहचान — यदि छवि बहुत धुंधली है (लैप्लासियन विचरण सीमा से नीचे), तो उपयोगकर्ता को पुनः लेने के लिए कहा जाता है
- तिरछापन पहचान — अत्यधिक कोणों पर ली गई रसीदें परिप्रेक्ष्य परिवर्तन के माध्यम से सुधारी जाती हैं
- कंट्रास्ट सामान्यीकरण — कम-कंट्रास्ट रसीदें (फीका थर्मल पेपर) अनुकूली हिस्टोग्राम समीकरण प्राप्त करती हैं
बहु-पृष्ठ समर्थन:
- एक पृष्ठ से लंबी रसीदें स्वचालित रूप से पहचानी जाती हैं (पृष्ठ विराम चिह्न, मुड़े हुए किनारे)
- बहु-पृष्ठ रसीदें प्रसंस्करण के लिए एक एकल दस्तावेज़ में सिल दी जाती हैं
Information
रसीदों की कच्ची फ़ोन तस्वीरें आश्चर्यजनक रूप से परिवर्तनशील होती हैं। अंधेरे रेस्तरां की रोशनी, किराने की दुकानों से झुर्रीदार थर्मल पेपर रसीदें, और फोल्ड लाइनों वाली रसीदें आम हैं। पूर्व-प्रसंस्करण इन्हें एक सुसंगत प्रारूप में सामान्यीकृत करता है जिसे दोनों OCR इंजन अच्छी तरह से संभालते हैं। इस चरण में गुणवत्ता जाँच 3–5% स्कैन को रोकती है जो अन्यथा अनुपयोगी परिणाम उत्पन्न करेंगे।
चरण 2: OCR निष्कर्षण — AWS Textract और Azure Document Intelligence
यह पाइपलाइन का मूल है। Yomio दो OCR प्रदाताओं का उपयोग करता है:
AWS Textract:
- मानक रसीदों के लिए प्राथमिक प्रदाता
- मुद्रित टेक्स्ट निष्कर्षण के लिए सर्वश्रेष्ठ-इन-क्लास
- रसीद API (Expense) विशेष रूप से रसीद लेआउट पर प्रशिक्षित
- पहचानता है: व्यापारी नाम, लेन-देन दिनांक, कुल, उप-योग, कर, लाइन आइटम, भुगतान विधि
Azure Document Intelligence (Form Recognizer):
- जटिल लेआउट वाली रसीदों के लिए द्वितीयक प्रदाता
- रसीदों के भीतर तालिका संरचनाओं का पता लगाने में बेहतर
- जब Textract विश्वास स्कोर सीमा से नीचे होता है तब फ़ॉलबैक के रूप में उपयोग किया जाता है
- हस्तलिखित रसीदों के लिए बेहतर हस्तलेखन पहचान
प्रदाता चयन तर्क:
- प्राथमिक प्रयास: AWS Textract
- यदि मुख्य क्षेत्रों पर Textract विश्वास < 70%: Azure Document Intelligence भी चलाएँ
- आउटपुट की तुलना करें — प्रत्येक क्षेत्र के लिए उच्च-विश्वास वाला परिणाम चुनें
- यदि दोनों सीमा से नीचे: मैन्युअल समीक्षा के लिए रसीद चिह्नित करें
यह दोहरा-प्रदाता आर्किटेक्चर का मतलब है कि यदि किसी प्रदाता के पास किसी विशिष्ट रसीद प्रारूप के लिए एक अंधा स्थान है (गैर-अंग्रेज़ी रसीदों या असामान्य लेआउट के साथ सामान्य), तो दूसरा प्रदाता क्षतिपूर्ति कर सकता है।
प्रत्येक प्रदाता क्या निकालता है
दोनों प्रदाता समान क्षेत्र निकालते हैं, लेकिन अलग-अलग ताकत के साथ:
| Field | Textract Strength | Azure Doc Intel Strength |
|---|---|---|
| Merchant name | High (standard) | High (standard) |
| Transaction date | High | High |
| Total amount | Very high | Very high |
| Line items | High (simple layouts) | High (table layouts) |
| Tax amount | Medium | High |
| Discounts | Medium | High (item-level) |
| Currency detection | High | High |
| Handwriting | Low | Medium |
चरण 3: सामान्यीकरण — डेटा को सुसंगत बनाना
कच्चा OCR आउटपुट सटीक है लेकिन गड़बड़ है। "Starbucks Coffee #4521" और "Starbucks" को एक ही व्यापारी के रूप में पहचाना जाना चाहिए। "05/08/2026" और "8 मई, 2026" को एक ही दिनांक होना चाहिए। यह चरण उन परिवर्तनों को संभालता है।
व्यापारी सामान्यीकरण:
- व्यापारी डेटाबेस (50,000 से अधिक व्यापारी) के विरुद्ध फ़ज़ी स्ट्रिंग मिलान
- ब्रांड-स्तरीय समूहीकरण: "Starbucks Coffee #4521" → "Starbucks"
- श्रृंखला पहचान: स्थानीय फ्रेंचाइजी उनके मूल ब्रांड से मैप की गई
- उपयोगकर्ता-परिभाषित उपनाम: यदि आप एक बार किसी व्यापारी का नाम बदलते हैं, तो सिस्टम इसे सीखता है
दिनांक सामान्यीकरण:
- रसीद से दिनांक प्रारूप का पता लगाता है (US: MM/DD/YYYY, EU: DD/MM/YYYY, ISO: YYYY-MM-DD)
- संदर्भ का उपयोग करके अस्पष्टता को हल करता है (03/04/2026 को यूके के एक व्यापारी से रसीद → 3 अप्रैल, 2026)
- व्यापारी स्थान से समय क्षेत्र का पता लगाना
मुद्रा सामान्यीकरण:
- मुद्रा प्रतीक पहचान ($, €, £, ¥, आदि)
- तीन-अक्षर कोड पहचान (USD, EUR, GBP)
- अस्पष्टता समाधान ($ USD, CAD, AUD, MXN हो सकता है — व्यापारी स्थान के माध्यम से हल किया गया)
राशि सत्यापन:
- क्रॉस-चेक: उप-योग + कर = कुल? लाइन-आइटम योग के विरुद्ध सत्यापित
- छूट पहचान: यदि लाइन आइटम योग घटा कुल > सीमा, तो छूट लागू की गई थी
- टिप पहचान (रेस्तरां रसीदें): जब टिप लाइन मौजूद हो तो उप-योग और कुल के बीच अंतर
चरण 4: वर्गीकरण — बुद्धिमान टैगिंग
निकाले गए लाइन आइटम को बजट श्रेणियों में निर्दिष्ट करने की आवश्यकता है। यह दो-परत प्रणाली के माध्यम से होता है:
परत 1: व्यापारी-आधारित नियम
- ज्ञात व्यापारियों के पास डिफ़ॉल्ट श्रेणी मैपिंग हैं
- "Kroger" → किराना (डिफ़ॉल्ट), "Shell" → परिवहन (डिफ़ॉल्ट), "Netflix" → मनोरंजन (डिफ़ॉल्ट)
- उपयोगकर्ता प्रति-व्यापारी ओवरराइड कर सकते हैं: "मैं चाहता हूँ कि Shell को परिवहन के रूप में वर्गीकृत किया जाए"
परत 2: आइटम-स्तरीय AI वर्गीकरण
- अज्ञात व्यापारियों या मिश्रित-श्रेणी की रसीदों के लिए (किराना और इलेक्ट्रॉनिक्स दोनों वाला Target)
- प्रत्येक लाइन आइटम को उत्पाद नाम, मूल्य और ऐतिहासिक डेटा के आधार पर अलग-अलग वर्गीकृत किया जाता है
- श्रेणियों में शामिल हैं: किराना, भोजन, परिवहन, खरीदारी, मनोरंजन, स्वास्थ्य सेवा, उपयोगिताएँ, आवास, शिक्षा, व्यक्तिगत देखभाल और 12+ उपश्रेणियाँ
वर्गीकरण विश्वास स्कोर यह निर्धारित करता है कि असाइनमेंट स्वचालित है या समीक्षा के लिए सुझाया गया है। 90%+ विश्वास पर, श्रेणी चुपचाप लागू की जाती है। इसके नीचे, इसे उपयोगकर्ता पुष्टि के लिए हाइलाइट किया जाता है।
चरण 5: संवर्धन — आपके खाते से कनेक्ट करना
अंतिम चरण संसाधित रसीद को आपके Yomio खाते से जोड़ता है:
- उपयोगकर्ता असाइनमेंट — रसीद आपके खाते (या परिवार समूह यदि साझाकरण सक्षम है) से लिंक होती है
- इन्वेंट्री अपडेट — ज्ञात इन्वेंट्री आइटम से मेल खाने वाले लाइन आइटम मात्रा अपडेट ट्रिगर करते हैं (हमारा इन्वेंट्री डीप डाइव देखें)
- सदस्यता पहचान — नियमित राशि वाले आवर्ती व्यापारी संभावित सदस्यता के रूप में चिह्नित किए जाते हैं
- बारकोड समाधान — स्कैन किए गए बारकोड को संवर्धन के लिए Open Food Facts और उत्पाद डेटाबेस से मिलान किया जाता है
- स्ट्रीक अपडेट — दैनिक स्ट्रीक काउंटर बढ़ाया जाता है
- XP पुरस्कार — स्कैनिंग XP आपके खाते में जमा किया जाता है
प्रसंस्करण समय और स्केलेबिलिटी
- औसत प्रसंस्करण समय: प्रति रसीद 2–6 सेकंड
- पीक थ्रूपुट: प्रति मिनट हजारों रसीदें (Lambda-आधारित ऑटो-स्केलिंग)
- भंडारण: S3 में रसीद छवियाँ, PostgreSQL में संरचित डेटा
- CDN: तेज़ पुनर्प्राप्ति के लिए CDN के माध्यम से रसीद छवियाँ परोसी जाती हैं
Tip
OCR प्रदाता स्वयं रसीद प्रसंस्करण के लिए 1–3 सेकंड लेते हैं। शेष समय पूर्व-प्रसंस्करण (0.5s), सामान्यीकरण (0.3s), वर्गीकरण (0.2s), और संवर्धन (0.5s) के बीच विभाजित होता है। बहु-पृष्ठ रसीदें पृष्ठ-दर-पृष्ठ प्रसंस्करण के कारण अधिक समय लेती हैं।
सटीकता बेंचमार्क
हम 10,000 रसीदों के मैन्युअल रूप से तैयार किए गए परीक्षण सेट के विरुद्ध पाइपलाइन सटीकता को लगातार मापते हैं:
| Metric | Current Accuracy |
|---|---|
| Total amount capture | 99.3% |
| Line-item extraction | 94.7% |
| Merchant detection | 98.1% |
| Date detection | 99.5% |
| Category assignment | 92.4% |
| Currency detection | 99.7% |
जहाँ अभी भी त्रुटियाँ होती हैं:
- हस्तलिखित रसीदें (मुद्रित की तुलना में 30% कम सटीकता)
- गंभीर रूप से क्षतिग्रस्त थर्मल पेपर (फीका, मुड़ा हुआ, फटा हुआ)
- गैर-मानक छूट संरचनाओं वाली रसीदें (BOGO, लॉयल्टी पॉइंट रिडेम्पशन)
- सूक्ष्म-मुद्रित नियम और शर्तें (OCR जानबूझकर इन्हें अनदेखा करता है)
Document review aid
Receipt review checklist
Choose the conditions you noticed, then review important extracted fields against the original. This checklist does not estimate OCR accuracy.
भविष्य में सुधार
पाइपलाइन को तीन क्षेत्रों में सक्रिय रूप से सुधारा जा रहा है:
1. हस्तलेखन पहचान। वर्तमान हस्तलेखन सटीकता सबसे बड़ा अंतर है। हम रसीद-विशिष्ट हस्तलेखन (टिप राशि, हस्तलिखित व्यापारी नाम, रसीदों पर व्यक्तिगत नोट) पर कस्टम मॉडल प्रशिक्षित कर रहे हैं।
2. रसीद प्रारूप कवरेज। अंतर्राष्ट्रीय रसीदों में अलग-अलग लेआउट, कर संरचनाएँ और भाषाएँ होती हैं। हम अधिक क्षेत्रीय प्रारूपों को कवर करने के लिए प्रदाता प्रशिक्षण डेटा का विस्तार कर रहे हैं।
3. रीयल-टाइम सुधार सुझाव। स्कैन करने के बाद मैन्युअल सुधार की आवश्यकता के बजाय, अगला पाइपलाइन संस्करण स्कैन प्रवाह के दौरान सुधार सुझाएगा — रसीद को अंतिम रूप देने से पहले।
OCR पाइपलाइन आज़माएँ
अभी किसी भी रसीद को स्कैन करें और पाइपलाइन को क्रिया में देखें। शटर से वर्गीकृत प्रविष्टि तक 10 सेकंड से भी कम समय में।
एक रसीद मुफ्त स्कैन करेंअक्सर पूछे जाने वाले प्रश्न
आगे पढ़ने के लिए
रसीद स्कैन बनाम मैन्युअल प्रविष्टि: 83% समय बचत डेटा
पाइपलाइन की गति मैन्युअल प्रविष्टि से कैसे तुलना करती है — वास्तविक परीक्षण परिणाम।
Yomio का AI कोपायलट आपके खर्च का विश्लेषण कैसे करता है
पाइपलाइन के बाद क्या होता है — Yopilot AI विश्लेषण के लिए संरचित डेटा का उपयोग करता है।
पैंट्री से खरीद तक: इन्वेंट्री और शॉपिंग लिस्ट ट्रैकिंग
पाइपलाइन डेटा स्वचालित रूप से इन्वेंट्री प्रबंधन में कैसे फ़ीड करता है।