Come funziona l'analisi degli scontrini: Dentro il pipeline OCR di Yomio (AWS + Azure)
Un'analisi tecnica approfondita del pipeline OCR per scontrini di Yomio — come AWS Textract e Azure Document Intelligence estraggono, normalizzano e categorizzano i dati degli scontrini su larga scala.

Alex Chen
Product Manager & Personal Finance Advocate
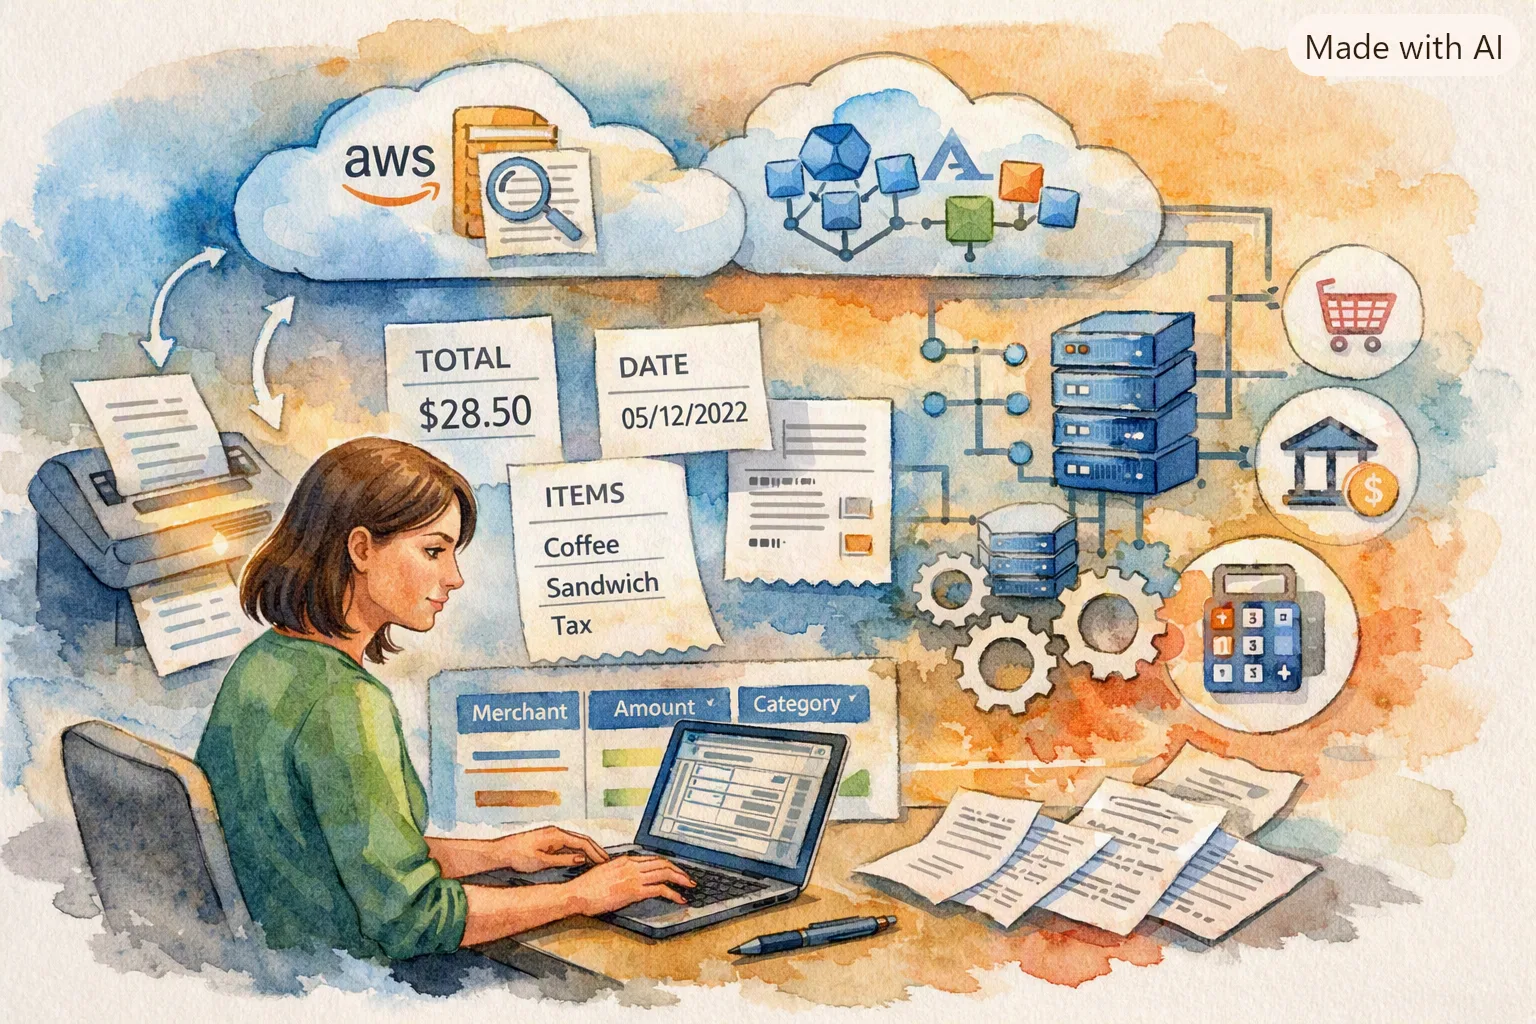
Come funziona l'analisi degli scontrini: Dentro il pipeline OCR di Yomio (AWS + Azure)
Quando scansioni uno scontrino in Yomio, succede molto tra la pressione del pulsante di scatto e la visualizzazione della transazione categorizzata nella tua dashboard. La foto del tuo scontrino viaggia attraverso un pipeline OCR a più fasi che estrae, normalizza e arricchisce il testo grezzo in dati finanziari strutturati.
Questo articolo analizza cosa succede all'interno di quel pipeline. È tecnico — ma è anche utile per capire perché alcuni scontrini vengono scansionati perfettamente e altri necessitano di correzioni, e come stiamo lavorando per colmare questo divario.
Punti chiave
- Yomio utilizza sia AWS Textract che Azure Document Intelligence — architettura a doppio fornitore per ridondanza e precisione
- Il pipeline ha 5 fasi: ingestione, estrazione OCR, normalizzazione, categorizzazione, arricchimento
- L'estrazione delle voci è il problema più difficile — gli scontrini non hanno un formato standard
- Il punteggio di confidenza segnala i campi a bassa confidenza per la revisione umana
- Supporto multimodale — riceve immagini, PDF e dati strutturati
- Precisione attuale: 94,7% estrazione voci, 99,3% acquisizione totale
- Tempo di elaborazione: 2–6 secondi per scontrino dalla scansione all'iscrizione categorizzata
Panoramica del pipeline
Il pipeline OCR ha cinque fasi:
- Ingestione — preelaborazione dell'immagine e validazione del formato
- Estrazione OCR — estrazione di testo e struttura tramite AWS Textract / Azure Document Intelligence
- Normalizzazione — corrispondenza del nome del commerciante, formattazione della data, rilevamento della valuta
- Categorizzazione — assegnazione della categoria a livello di voce e totale
- Arricchimento — ricerca codice a barre, dati prodotto, collegamento account utente
Ogni fase ha fallback integrati. Se una fase produce output a bassa confidenza, il pipeline lo segnala invece di propagare dati errati.
Fase 1: Ingestione — Preelaborazione dell'immagine
Prima che i motori OCR tocchino lo scontrino, l'immagine passa attraverso la preelaborazione:
Normalizzazione del formato:
- Le foto vengono ridimensionate a un massimo di 2048px sul bordo più lungo
- Viene applicata la compressione JPEG (qualità 85%) per l'efficienza di archiviazione
- Le pagine PDF vengono renderizzate come immagini a 300 DPI
Controlli di qualità:
- Rilevamento sfocatura — se l'immagine è troppo sfocata (varianza Laplaciana sotto la soglia), viene chiesto all'utente di rifare la foto
- Rilevamento inclinazione — gli scontrini fotografati ad angoli estremi vengono corretti tramite trasformazione prospettica
- Normalizzazione del contrasto — gli scontrini a basso contrasto (carta termica sbiadita) ricevono equalizzazione adattiva dell'istogramma
Supporto multipagina:
- Gli scontrini più lunghi di una pagina vengono rilevati automaticamente (marcatori di interruzione di pagina, bordi piegati)
- Gli scontrini multipagina vengono uniti in un unico documento per l'elaborazione
Informazione
Le foto grezze degli scontrini sono sorprendentemente variabili. L'illuminazione scura dei ristoranti, gli scontrini in carta termica sgualciti dei supermercati e gli scontrini con linee di piegatura sono comuni. La preelaborazione li normalizza in un formato coerente che entrambi i motori OCR gestiscono bene. I controlli di qualità in questa fase prevengono il 3–5% delle scansioni che altrimenti produrrebbero risultati inutilizzabili.
Fase 2: Estrazione OCR — AWS Textract e Azure Document Intelligence
Questo è il cuore del pipeline. Yomio utilizza due fornitori OCR:
AWS Textract:
- Fornitore principale per scontrini standard
- Il migliore della categoria per l'estrazione di testo stampato
- API scontrini (Expense) specificamente addestrata sui layout degli scontrini
- Rileva: nome del commerciante, data della transazione, totale, subtotale, tasse, voci, metodo di pagamento
Azure Document Intelligence (Form Recognizer):
- Fornitore secondario per scontrini con layout complessi
- Migliore nel rilevare strutture tabellari all'interno degli scontrini
- Utilizzato come fallback quando i punteggi di confidenza di Textract sono sotto la soglia
- Migliore rilevamento della scrittura a mano per scontrini scritti a mano
Logica di selezione del fornitore:
- Tentativo principale: AWS Textract
- Se la confidenza di Textract < 70% sui campi chiave: esegui anche Azure Document Intelligence
- Confronta gli output — scegli il risultato con maggiore confidenza per ogni campo
- Se entrambi sotto la soglia: segnala lo scontrino per revisione manuale
Questa architettura a doppio fornitore significa che se un fornitore ha un punto cieco per un formato di scontrino specifico (comune con scontrini non inglesi o layout insoliti), l'altro fornitore può compensare.
Cosa estrae ogni fornitore
Entrambi i fornitori estraggono campi simili, ma con punti di forza diversi:
| Field | Textract Strength | Azure Doc Intel Strength |
|---|---|---|
| Merchant name | High (standard) | High (standard) |
| Transaction date | High | High |
| Total amount | Very high | Very high |
| Line items | High (simple layouts) | High (table layouts) |
| Tax amount | Medium | High |
| Discounts | Medium | High (item-level) |
| Currency detection | High | High |
| Handwriting | Low | Medium |
Fase 3: Normalizzazione — Rendere i dati coerenti
L'output OCR grezzo è accurato ma disordinato. "Starbucks Coffee #4521" e "Starbucks" devono essere riconosciuti come lo stesso commerciante. "05/08/2026" e "8 maggio 2026" devono essere la stessa data. Questa fase gestisce queste trasformazioni.
Normalizzazione del commerciante:
- Corrispondenza fuzzy di stringhe contro un database di commercianti (oltre 50.000 commercianti)
- Raggruppamento a livello di marca: "Starbucks Coffee #4521" → "Starbucks"
- Identificazione della catena: franchising locali mappati al loro marchio madre
- Alias definiti dall'utente: se rinomini un commerciante una volta, il sistema lo impara
Normalizzazione della data:
- Rileva il formato della data dallo scontrino (US: MM/GG/AAAA, EU: GG/MM/AAAA, ISO: AAAA-MM-GG)
- Risolve l'ambiguità usando il contesto (uno scontrino di un commerciante britannico il 03/04/2026 → 3 aprile 2026)
- Rilevamento del fuso orario dalla posizione del commerciante
Normalizzazione della valuta:
- Rilevamento dei simboli di valuta ($, €, £, ¥, ecc.)
- Rilevamento del codice a tre lettere (USD, EUR, GBP)
- Risoluzione dell'ambiguità ($ potrebbe essere USD, CAD, AUD, MXN — risolto tramite la posizione del commerciante)
Validazione dell'importo:
- Controlli incrociati: subtotale + tasse = totale? Verificato contro la somma delle voci
- Rilevamento sconti: se la somma delle voci meno il totale > soglia, è stato applicato uno sconto
- Rilevamento mance (scontrini di ristoranti): differenza tra subtotale e totale quando esiste una riga per la mancia
Fase 4: Categorizzazione — Tagging intelligente
Le voci estratte devono essere assegnate a categorie di budget. Questo avviene attraverso un sistema a due livelli:
Livello 1: Regole basate sul commerciante
- I commercianti noti hanno mappature di categoria predefinite
- "Kroger" → Alimentari (predefinito), "Shell" → Trasporti (predefinito), "Netflix" → Intrattenimento (predefinito)
- Gli utenti possono sovrascrivere per commerciante: "Voglio che Shell sia categorizzato come Trasporti"
Livello 2: Categorizzazione AI a livello di articolo
- Per commercianti sconosciuti o scontrini a categorie miste (Target con sia alimentari che elettronica)
- Ogni voce viene categorizzata separatamente in base a nome prodotto, prezzo e dati storici
- Le categorie includono: Alimentari, Ristorazione, Trasporti, Shopping, Intrattenimento, Sanità, Utenze, Abitazione, Istruzione, Cura personale e 12+ sottocategorie
Il punteggio di confidenza della categorizzazione determina se l'assegnazione è automatica o suggerita per la revisione. Con confidenza al 90%+, la categoria viene applicata silenziosamente. Al di sotto, viene evidenziata per la conferma dell'utente.
Fase 5: Arricchimento — Connessione al tuo account
La fase finale collega lo scontrino elaborato al tuo account Yomio:
- Assegnazione utente — lo scontrino viene collegato al tuo account (o gruppo familiare se la condivisione è abilitata)
- Aggiornamento inventario — le voci corrispondenti a articoli di inventario noti attivano aggiornamenti di quantità (vedi il nostro approfondimento sull'inventario)
- Rilevamento abbonamenti — i commercianti ricorrenti con importi regolari vengono segnalati come potenziali abbonamenti
- Risoluzione codice a barre — i codici a barre scansionati vengono confrontati con Open Food Facts e database di prodotti per l'arricchimento
- Aggiornamento serie — il contatore delle serie giornaliere viene incrementato
- Ricompensa XP — gli XP di scansione vengono accreditati sul tuo account
Tempo di elaborazione e scalabilità
- Tempo medio di elaborazione: 2–6 secondi per scontrino
- Throughput di picco: migliaia di scontrini al minuto (auto-scaling basato su Lambda)
- Archiviazione: immagini degli scontrini in S3, dati strutturati in PostgreSQL
- CDN: immagini degli scontrini servite tramite CDN per un recupero rapido
Suggerimento
I fornitori OCR stessi impiegano 1–3 secondi per l'elaborazione dello scontrino. Il tempo rimanente è suddiviso tra preelaborazione (0,5 s), normalizzazione (0,3 s), categorizzazione (0,2 s) e arricchimento (0,5 s). Gli scontrini multipagina richiedono più tempo a causa dell'elaborazione pagina per pagina.
Benchmark di precisione
Misuriamo continuamente la precisione del pipeline contro un set di test curato manualmente di 10.000 scontrini:
| Metric | Current Accuracy |
|---|---|
| Total amount capture | 99,3% |
| Line-item extraction | 94,7% |
| Merchant detection | 98,1% |
| Date detection | 99,5% |
| Category assignment | 92,4% |
| Currency detection | 99,7% |
Dove si verificano ancora errori:
- Scontrini scritti a mano (precisione inferiore del 30% rispetto a quelli stampati)
- Carta termica gravemente danneggiata (sbiadita, arricciata, strappata)
- Scontrini con strutture di sconto non standard (BOGO, riscatti di punti fedeltà)
- Termini e condizioni micro-stampati (l'OCR li ignora intenzionalmente)
Document review aid
Receipt review checklist
Choose the conditions you noticed, then review important extracted fields against the original. This checklist does not estimate OCR accuracy.
Miglioramenti futuri
Il pipeline è attivamente in miglioramento in tre aree:
1. Riconoscimento della scrittura a mano. La precisione attuale della scrittura a mano è il divario più grande. Stiamo addestrando modelli personalizzati sulla scrittura a mano specifica degli scontrini (importi delle mance, nomi di commercianti scritti a mano, note personali sugli scontrini).
2. Copertura dei formati degli scontrini. Gli scontrini internazionali hanno layout, strutture fiscali e lingue diverse. Stiamo espandendo i dati di addestramento dei fornitori per coprire più formati regionali.
3. Suggerimenti di correzione in tempo reale. Invece di richiedere correzioni manuali dopo la scansione, la prossima versione del pipeline suggerirà correzioni durante il flusso di scansione — prima che lo scontrino sia finalizzato.
Prova il pipeline OCR
Scansiona qualsiasi scontrino ora e vedi il pipeline in azione. Dallo scatto all\'iscrizione categorizzata in meno di 10 secondi.
Scansiona uno scontrino gratisDomande frequenti
Ulteriori letture
Scansione scontrini vs. inserimento manuale: 83% di risparmio di tempo
Come la velocità del pipeline si confronta con l'inserimento manuale — risultati di test reali.
Come l'AI Copilot di Yomio analizza le tue spese
Cosa succede dopo il pipeline — Yopilot utilizza i dati strutturati per l'analisi AI.
Dalla dispensa all'acquisto: Tracciamento inventario e liste della spesa
Come i dati del pipeline alimentano automaticamente la gestione dell'inventario.