Sådan fungerer kvitteringsparsing: Inde i Yomios OCR-pipeline (AWS + Azure)
Et teknisk dyk ned i Yomios OCR-pipeline for kvitteringer – hvordan AWS Textract og Azure Document Intelligence udtrækker, normaliserer og kategoriserer kvitteringsdata i skala.

Alex Chen
Produktchef & Privatøkonomi-advokat
Sådan fungerer kvitteringsparsing: Inde i Yomios OCR-pipeline (AWS + Azure)
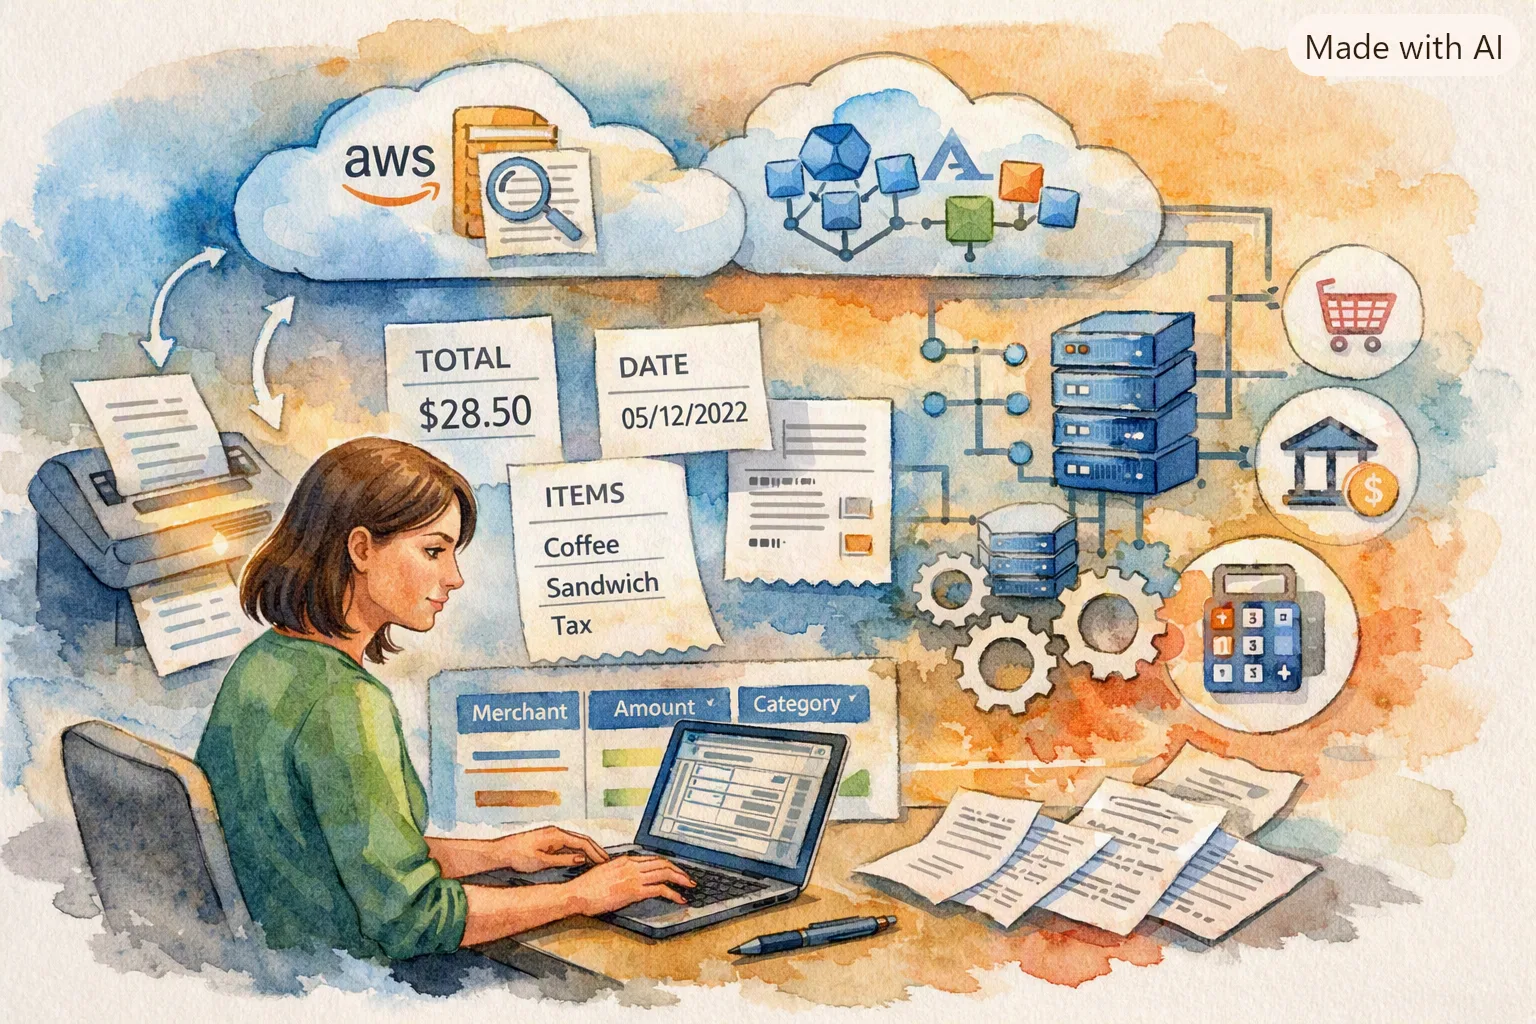
Når du scanner en kvittering i Yomio, sker der meget mellem at trykke på udløserknappen og se den kategoriserede transaktion i dit dashboard. Dit kvitteringsfoto rejser gennem en flertrins OCR-pipeline, der udtrækker, normaliserer og beriger råteksten til strukturerede finansielle data.
Denne artikel gennemgår, hvad der sker inde i pipelinen. Den er teknisk — men også nyttig for at forstå, hvorfor nogle kvitteringer scannes perfekt, og andre har brug for rettelser, og hvordan vi arbejder på at lukke det hul.
Vigtige pointer
- Yomio bruger både AWS Textract og Azure Document Intelligence — dobbeltudbyder-arkitektur for redundans og nøjagtighed
- Pipeline har 5 faser: indtag, OCR-udtræk, normalisering, kategorisering, berigelse
- Linjeelement-udtræk er det sværeste problem — kvitteringer har intet standardformat
- Konfidensscoring markerer lavkonfidensfelter til manuel gennemgang
- Multimodal understøttelse — modtager billeder, PDF'er og strukturerede data
- Nuværende nøjagtighed: 94,7 % linjeelement-udtræk, 99,3 % total fangst
- Behandlingstid: 2–6 sekunder pr. kvittering fra scanning til kategoriseret indtastning
Pipeline-overblik
OCR-pipelinen har fem faser:
- Indtag — billedforbehandling og formatvalidering
- OCR-udtræk — tekst- og strukturudtræk via AWS Textract / Azure Document Intelligence
- Normalisering — sammenligning af handlendes navne, datoformatering, valutaidentifikation
- Kategorisering — tildeling af kategori på linje- og totalniveau
- Berigelse — stregkodeopslag, produktdata, brugerkontotilknytning
Hver fase har indbyggede fallbacks. Hvis en fase producerer output med lav konfidens, markerer pipelinen det i stedet for at sende dårlige data videre.
Fase 1: Indtag — Billedforbehandling
Før OCR-motorer rører kvitteringen, gennemgår billedet forbehandling:
Formatnormalisering:
- Fotos skaleres til maksimalt 2048px på den længste kant
- JPEG-komprimering anvendes (kvalitet 85 %) for lagringseffektivitet
- PDF-sider gengives som billeder ved 300 DPI
Kvalitetstjek:
- Sløringsfølsomhed — hvis billedet er for sløret (Laplacian-varians under tærskel), bliver brugeren bedt om at tage et nyt
- Skævhedsfølsomhed — kvitteringer taget i ekstreme vinkler rettes via perspektivtransformering
- Kontrastnormalisering — kvitteringer med lav kontrast (blegnet termopapir) får adaptiv histogramudligning
Understøttelse af flere sider:
- Kvitteringer længere end én side registreres automatisk (sideskiftmarkører, foldede kanter)
- Fler-siders kvitteringer samles til ét dokument til behandling
Information
Rå telefonbilleder af kvitteringer er overraskende varierende. Mørk restaurantbelysning, krøllet termopapir fra dagligvarebutikker og kvitteringer med foldelinjer er almindelige. Forbehandling normaliserer disse til et ensartet format, som begge OCR-motorer håndterer godt. Kvalitetstjek på dette trin forhindrer de 3–5 % af scanninger, der ellers ville give ubrugelige resultater.
Fase 2: OCR-udtræk — AWS Textract og Azure Document Intelligence
Dette er kernen i pipelinen. Yomio bruger to OCR-udbydere:
AWS Textract:
- Primær udbyder til standardkvitteringer
- Bedst i klassen til udtræk af trykt tekst
- Receipt API (Expense) specifikt trænet på kvitteringslayouts
- Registrerer: handlendes navn, transaktionsdato, total, subtotal, moms, linjeelementer, betalingsmetode
Azure Document Intelligence (Form Recognizer):
- Sekundær udbyder til kvitteringer med komplekse layouts
- Bedre til at registrere tabeller i kvitteringer
- Bruges som fallback, når Textracts konfidensscorer er under tærskel
- Bedre håndskriftsregistrering til håndskrevne kvitteringer
Logik for udbydervalg:
- Primært forsøg: AWS Textract
- Hvis Textract-konfidens < 70 % på nøglefelter: kør også Azure Document Intelligence
- Sammenlign output — vælg resultatet med højest konfidens for hvert felt
- Hvis begge er under tærskel: markér kvittering til manuel gennemgang
Denne dobbeltudbyder-arkitektur betyder, at hvis en udbyder har et blindt punkt for et bestemt kvitteringsformat (almindeligt med ikke-engelske kvitteringer eller usædvanlige layouts), kan den anden udbyder kompensere.
Hvad hver udbyder udtrækker
Begge udbydere udtrækker lignende felter, men med forskellige styrker:
| Field | Textract Strength | Azure Doc Intel Strength |
|---|---|---|
| Merchant name | High (standard) | High (standard) |
| Transaction date | High | High |
| Total amount | Very high | Very high |
| Line items | High (simple layouts) | High (table layouts) |
| Tax amount | Medium | High |
| Discounts | Medium | High (item-level) |
| Currency detection | High | High |
| Handwriting | Low | Medium |
Fase 3: Normalisering — Gør data konsistente
Rå OCR-output er præcist, men rodet. "Starbucks Coffee #4521" og "Starbucks" skal genkendes som samme handlende. "05/08/2026" og "8. maj 2026" skal være samme dato. Denne fase håndterer disse transformationer.
Handlende-normalisering:
- Fuzzy-strengsammenligning mod en handlende-database (over 50.000 handlende)
- Gruppering på mærkeniveau: "Starbucks Coffee #4521" → "Starbucks"
- Kædeidentifikation: lokale franchises kortlagt til deres modermærke
- Brugerdefinerede aliaser: hvis du omdøber en handlende én gang, lærer systemet det
Datonormalisering:
- Registrerer datoformat fra kvittering (US: MM/DD/YYYY, EU: DD/MM/YYYY, ISO: YYYY-MM-DD)
- Løser tvetydighed ved hjælp af kontekst (en kvittering fra en britisk handlende den 03/04/2026 → 3. april 2026)
- Tidszoneidentifikation fra handlendes placering
Valutanormalisering:
- Registrering af valutasymboler ($, €, £, ¥, osv.)
- Tre-bogstavs kodeidentifikation (USD, EUR, GBP)
- Tvetydighedsopløsning ($ kunne være USD, CAD, AUD, MXN — løst via handlendes placering)
Beløbsvalidering:
- Krydstjek: subtotal + moms = total? Bekræftet mod summen af linjeelementer
- Rabatregistrering: hvis sum af linjeelementer minus total > tærskel, blev en rabat anvendt
- Drikkepenge-registrering (restaurantkvitteringer): forskel mellem subtotal og total, når drikkepengelinje findes
Fase 4: Kategorisering — Intelligent tagging
Udtrækne linjeelementer skal tildeles budgetkategorier. Dette sker gennem et to-lags system:
Lag 1: Handlende-baserede regler
- Kendte handlende har standardkategoritilknytninger
- "Kroger" → Dagligvarer (standard), "Shell" → Transport (standard), "Netflix" → Underholdning (standard)
- Brugere kan tilsidesætte pr. handlende: "Jeg vil have Shell kategoriseret som Transport"
Lag 2: AI-kategorisering på vareniveau
- For ukendte handlende eller kvitteringer med blandede kategorier (Target med både dagligvarer og elektronik)
- Hvert linjeelement kategoriseres separat baseret på produktnavn, pris og historiske data
- Kategorier inkluderer: Dagligvarer, Spisning, Transport, Shopping, Underholdning, Sundhed, Forsyning, Bolig, Uddannelse, Personlig pleje og 12+ underkategorier
Kategoriseringskonfidensscoren bestemmer, om tildelingen er automatisk eller foreslået til gennemgang. Ved 90 %+ konfidens anvendes kategorien stille. Under det markeres den til brugerbekræftelse.
Fase 5: Berigelse — Forbindelse til din konto
Den sidste fase forbinder den behandlede kvittering til din Yomio-konto:
- Brugertildeling — kvitteringen linkes til din konto (eller familiegruppe, hvis deling er aktiveret)
- Lageropdatering — linjeelementer, der matcher kendte lagervarer, udløser mængdeopdateringer (se vores lager-dyk)
- Abonnementsregistrering — tilbagevendende handlende med regelmæssige beløb markeres som potentielle abonnementer
- Stregkodeopløsning — scannede stregkoder matches mod Open Food Facts og produktdatabaser til berigelse
- Streak-opdatering — den daglige streak-tæller øges
- XP-tildeling — scanning-XP krediteres din konto
Behandlingstid og skalerbarhed
- Gennemsnitlig behandlingstid: 2–6 sekunder pr. kvittering
- Maksimal gennemstrømning: tusindvis af kvitteringer pr. minut (Lambda-baseret auto-skala)
- Lagring: kvitteringsbilleder i S3, strukturerede data i PostgreSQL
- CDN: kvitteringsbilleder serveres via CDN for hurtig hentning
Tip
OCR-udbyderne selv tager 1–3 sekunder til kvitteringsbehandling. Den resterende tid deles mellem forbehandling (0,5 s), normalisering (0,3 s), kategorisering (0,2 s) og berigelse (0,5 s). Fler-siders kvitteringer tager længere tid på grund af side-for-side-behandling.
Nøjagtighedsbenchmarks
Vi måler løbende pipeline-nøjagtigheden mod et manuelt kurateret testsæt på 10.000 kvitteringer:
| Metric | Current Accuracy |
|---|---|
| Total amount capture | 99.3 % |
| Line-item extraction | 94.7 % |
| Merchant detection | 98.1 % |
| Date detection | 99.5 % |
| Category assignment | 92.4 % |
| Currency detection | 99.7 % |
Hvor fejl stadig opstår:
- Håndskrevne kvitteringer (30 % lavere nøjagtighed end trykte)
- Alvorligt beskadiget termopapir (blegnet, krøllet, revet)
- Kvitteringer med ikke-standard rabatstrukturer (BOGO, loyalitetspoint-indløsninger)
- Mikroprintede vilkår og betingelser (OCR ignorerer disse bevidst)
Document review aid
Receipt review checklist
Choose the conditions you noticed, then review important extracted fields against the original. This checklist does not estimate OCR accuracy.
Fremtidige forbedringer
Pipelinen forbedres aktivt på tre områder:
1. Håndskriftsgenkendelse. Nuværende håndskriftsnøjagtighed er det største hul. Vi træner brugerdefinerede modeller på kvitteringsspecifik håndskrift (drikkepengebeløb, håndskrevne handlendenavne, personlige noter på kvitteringer).
2. Dækning af kvitteringsformater. Internationale kvitteringer har forskellige layouts, momsstrukturer og sprog. Vi udvider udbydernes træningsdata til at dække flere regionale formater.
3. Realtidskorrektionsforslag. I stedet for at kræve manuel korrektion efter scanning, vil næste pipeline-version foreslå rettelser under scanningsflowet — før kvitteringen er færdiggjort.
Ofte stillede spørgsmål
Gennemgå oplysninger fra en kvittering
Scan eller upload en kvittering, og kontrollér de udtrukne felter. Ret manglende eller forkerte oplysninger før du bruger registreringen.
Scan en kvittering gratisYderligere læsning
Kvitteringsscanning vs. Manuel indtastning: 83 % tidsbesparelse
Hvordan pipelinens hastighed sammenlignes med manuel indtastning — rigtige testresultater.
Hvordan Yomios AI-copilot analyserer dine udgifter
Hvad sker der efter pipelinen — Yopilot bruger de strukturerede data til AI-analyse.
Fra spisekammer til køb: Sporing af lager og indkøbslister
Hvordan pipelinedata automatisk fodrer ind i lagerstyring.