Comment Fonctionne l'Analyse des Reçus : Pipeline OCR de Yomio (AWS + Azure)
Une plongée technique approfondie dans le pipeline OCR de reçus de Yomio — comment AWS Textract et Azure Document Intelligence extraient, normalisent et catégorisent les données de reçus à grande échelle.

Alex Chen
Chef de Produit et Défenseur de la Finance Personnelle
Comment Fonctionne l'Analyse des Reçus : Pipeline OCR de Yomio (AWS + Azure)
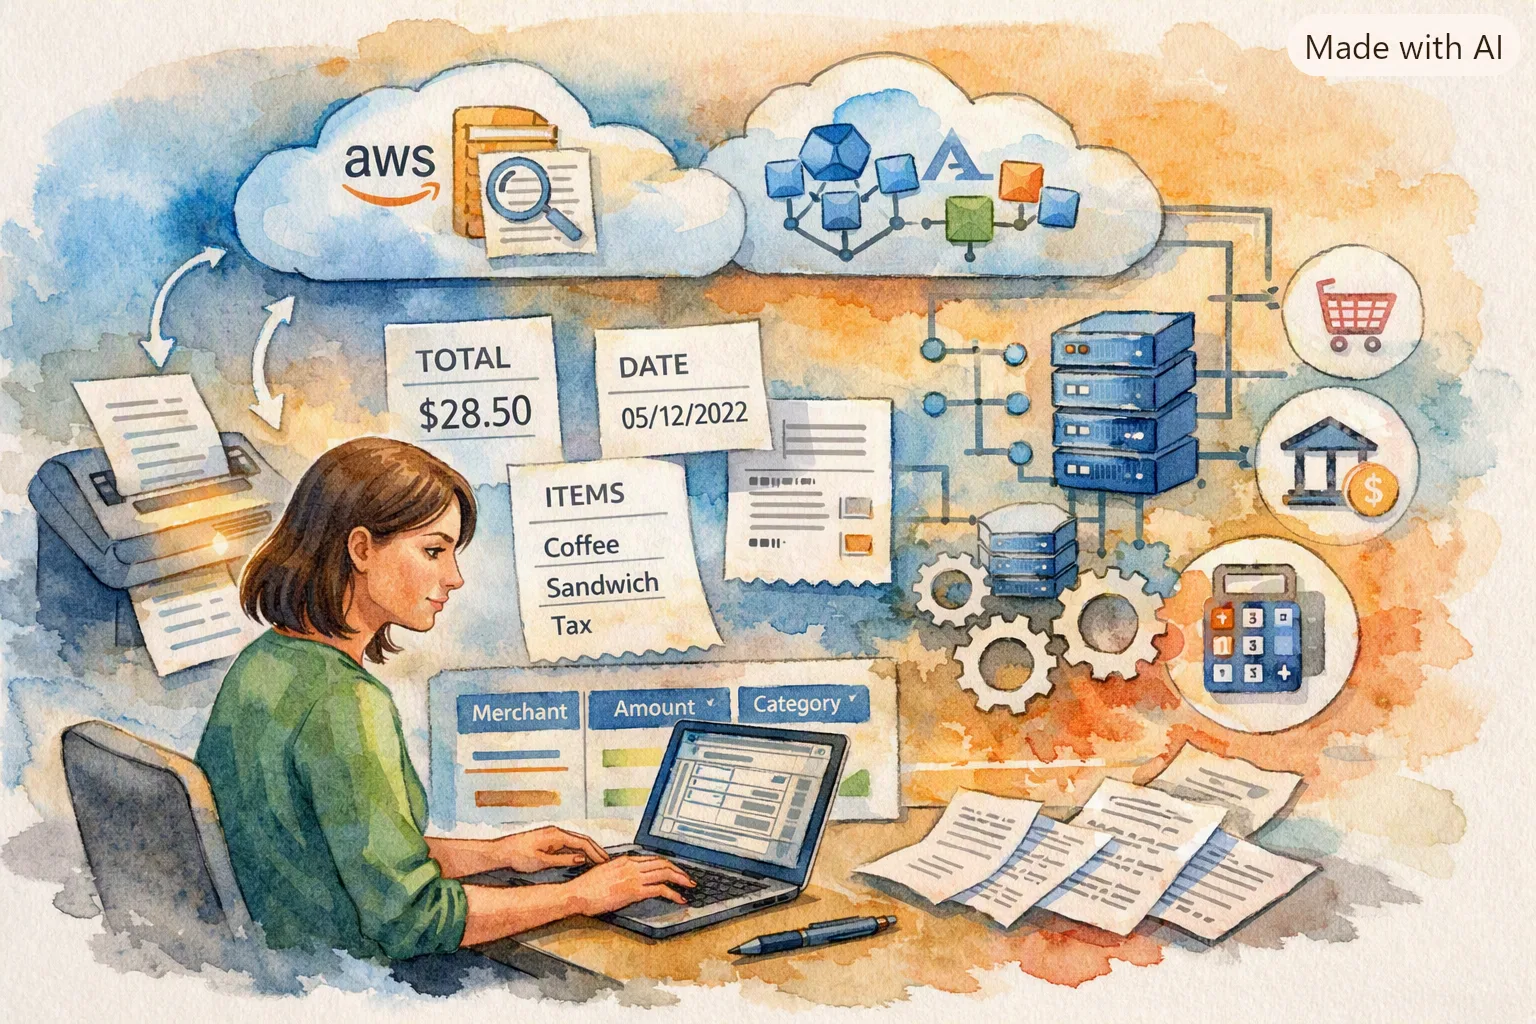
Quand vous scannez un reçu dans Yomio, beaucoup de choses se passent entre l'appui sur le bouton de l'obturateur et l'affichage de la transaction catégorisée dans votre tableau de bord. Votre photo de reçu traverse un pipeline OCR multi-étapes qui extrait, normalise et enrichit le texte brut en données financières structurées.
Cet article vous guide à travers ce qui se passe à l'intérieur de ce pipeline. C'est technique — mais c'est aussi utile pour comprendre pourquoi certains reçus se numérisent parfaitement et d'autres nécessitent des corrections, et comment nous travaillons pour combler cet écart.
Points Clés à Retenir
- Yomio utilise à la fois AWS Textract et Azure Document Intelligence — architecture à double fournisseur pour la redondance et la précision
- Le pipeline comporte 5 étapes : ingestion, extraction OCR, normalisation, catégorisation, enrichissement
- L'extraction des lignes d'articles est le problème le plus difficile — les reçus n'ont pas de format standard
- Le score de confiance signale les champs de faible confiance pour examen manuel
- Support multimodal — reçoit des images, des PDF, et des données structurées
- Précision actuelle : 94,7 % pour l'extraction des lignes d'articles, 99,3 % pour la capture totale
- Temps de traitement : 2-6 secondes par reçu, du scan à l'entrée catégorisée
Aperçu du Pipeline
Le pipeline OCR comporte cinq étapes :
- Ingestion — prétraitement de l'image et validation du format
- Extraction OCR — extraction de texte et de structure via AWS Textract / Azure Document Intelligence
- Normalisation — correspondance du nom du commerçant, formatage de la date, détection de la devise
- Catégorisation — attribution de catégories au niveau des lignes d'articles et du total
- Enrichissement — recherche de codes-barres, données produit, liaison de compte utilisateur
Chaque étape comporte des solutions de repli intégrées. Si une étape produit une sortie de faible confiance, le pipeline la signale plutôt que de propager des données incorrectes.
Étape 1 : Ingestion — Prétraitement de l'Image
Avant que les moteurs OCR ne touchent au reçu, l'image passe par un prétraitement :
Normalisation du format :
- Les photos sont redimensionnées à un maximum de 2048px sur le côté le plus long
- La compression JPEG est appliquée (qualité 85 %) pour l'efficacité du stockage
- Les pages PDF sont rendues en images à 300 DPI
Vérifications de qualité :
- Détection du flou — si l'image est trop floue (variance laplacienne en dessous du seuil), on vous demande de reprendre
- Détection du biais — les reçus photographiés à des angles extrêmes sont corrigés via transformation de perspective
- Normalisation du contraste — les reçus de faible contraste (papier thermique décoloré) obtiennent une égalisation d'histogramme adaptative
Support multi-pages :
- Les reçus plus longs qu'une page sont automatiquement détectés (marqueurs de saut de page, bords pliés)
- Les reçus multi-pages sont assemblés en un seul document pour le traitement
Information
Les photos brutes des reçus prise avec le téléphone sont étonnamment variables. L'éclairage sombre du restaurant, les reçus froissés en papier thermique d'épicerie, et les reçus avec des lignes de pli sont courants. Le prétraitement normalise ces éléments à un format cohérent que les deux moteurs OCR gèrent bien. Les vérifications de qualité à cette étape évitent les 3-5 % de numérisations qui produiraient autrement des résultats inutilisables.
Étape 2 : Extraction OCR — AWS Textract et Azure Document Intelligence
C'est le cœur du pipeline. Yomio utilise deux fournisseurs OCR :
AWS Textract :
- Fournisseur principal pour les reçus standard
- Meilleure extraction de texte imprimé de sa catégorie
- API de reçu (Expense) spécifiquement entraîné sur les mises en page de reçus
- Détecte : nom du commerçant, date de transaction, total, sous-total, taxe, lignes d'articles, mode de paiement
Azure Document Intelligence (Form Recognizer) :
- Fournisseur secondaire pour les reçus avec mises en page complexes
- Meilleur à la détection des structures de tableaux au sein des reçus
- Utilisé comme solution de repli quand les scores de confiance de Textract sont en dessous du seuil
- Meilleure détection de l'écriture manuscrite pour les reçus manuscrits
Logique de sélection du fournisseur :
- Tentative principale : AWS Textract
- Si la confiance de Textract < 70 % sur les champs clés : exécuter également Azure Document Intelligence
- Comparer les sorties — choisir le résultat de confiance plus élevée pour chaque champ
- Si les deux sont en dessous du seuil : signaler le reçu pour examen manuel
Cette architecture à double fournisseur signifie que si un fournisseur a un point aveugle pour un format de reçu spécifique (courant avec les reçus non-anglais ou les mises en page inhabituelles), l'autre fournisseur peut compenser.
Ce que Chaque Fournisseur Extrait
Les deux fournisseurs extraient des champs similaires, mais avec des forces différentes :
| Champ | Force de Textract | Force d'Azure Doc Intel |
|---|---|---|
| Nom du commerçant | Haute (standard) | Haute (standard) |
| Date de transaction | Haute | Haute |
| Montant total | Très haute | Très haute |
| Lignes d'articles | Haute (mises en page simples) | Haute (mises en page avec tableaux) |
| Montant de taxe | Moyenne | Haute |
| Remises | Moyenne | Haute (niveau article) |
| Détection de devise | Haute | Haute |
| Écriture manuscrite | Basse | Moyenne |
Étape 3 : Normalisation — Rendre les Données Cohérentes
La sortie OCR brute est exacte mais désordonnée. « Starbucks Coffee #4521 » et « Starbucks » doivent être reconnus comme le même commerçant. « 05/08/2026 » et « May 8, 2026 » doivent être la même date. Cette étape gère ces transformations.
Normalisation du commerçant :
- Correspondance de chaîne floue contre une base de données de commerçants (plus de 50 000 commerçants)
- Regroupement au niveau de la marque : « Starbucks Coffee #4521 » → « Starbucks »
- Identification de la chaîne : les franchises locales mappées à leur marque parent
- Alias définis par l'utilisateur : si vous renommez un commerçant une fois, le système l'apprend
Normalisation de la date :
- Détecte le format de date du reçu (US : MM/DD/YYYY, EU : DD/MM/YYYY, ISO : YYYY-MM-DD)
- Résout l'ambiguïté en utilisant le contexte (un reçu d'un commerçant britannique le 03/04/2026 → 3 avril 2026)
- Détection du fuseau horaire à partir de l'emplacement du commerçant
Normalisation de la devise :
- Détection du symbole de devise ($, €, £, ¥, etc.)
- Détection du code à trois lettres (USD, EUR, GBP)
- Résolution de l'ambiguïté ($ pourrait être USD, CAD, AUD, MXN — résolu via l'emplacement du commerçant)
Validation du montant :
- Vérifications croisées : sous-total + taxe = total ? Vérifiés contre la somme des lignes d'articles
- Détection de remise : si les lignes d'articles se résument moins le total > seuil, une remise a été appliquée
- Détection du pourboire (reçus de restaurant) : différence entre le sous-total et le total quand la ligne de pourboire existe
Étape 4 : Catégorisation — Marquage Intelligent
Les articles extraits doivent être assignés à des catégories budgétaires. Cela se fait via un système à deux couches :
Couche 1 : Règles basées sur le commerçant
- Les commerçants connus ont des mappages de catégories par défaut
- « Kroger » → Épicerie (par défaut), « Shell » → Transport (par défaut), « Netflix » → Divertissement (par défaut)
- Les utilisateurs peuvent remplacer par commerçant : « Je veux que Shell soit catégorisé comme Transport »
Couche 2 : Catégorisation IA au niveau de l'article
- Pour les commerçants inconnus ou les reçus de catégories mixtes (Target avec épicerie et électronique)
- Chaque ligne d'article est catégorisée séparément en fonction du nom du produit, du prix, et des données historiques
- Les catégories incluent : Épicerie, Repas, Transport, Shopping, Divertissement, Santé, Services, Logement, Éducation, Soins Personnels, et 12+ sous-catégories
Le score de confiance de catégorisation détermine si l'assignation est automatique ou suggérée pour examen. À 90 %+ de confiance, la catégorie est appliquée silencieusement. En dessous de cela, elle est surlignée pour confirmation de l'utilisateur.
Étape 5 : Enrichissement — Connexion à Votre Compte
L'étape finale connecte le reçu traité à votre compte Yomio :
- Assignation d'utilisateur — le reçu est lié à votre compte (ou groupe familial si le partage est activé)
- Mise à jour d'inventaire — les lignes d'articles correspondant aux articles d'inventaire connus déclenchent les mises à jour de quantité (voir notre approfondissement d'inventaire)
- Détection d'abonnement — les commerçants récurrents avec des montants réguliers sont signalés comme abonnements potentiels
- Résolution de code-barres — les codes-barres numérisés sont appariés contre Open Food Facts et les bases de données de produits pour l'enrichissement
- Mise à jour de série — le compteur de série quotidienne est incrémenté
- Allocation XP — le XP de numérisation est accrédité à votre compte
Temps de Traitement et Scalabilité
- Temps de traitement moyen : 2-6 secondes par reçu
- Débit de pointe : milliers de reçus par minute (mise à l'échelle automatique basée sur Lambda)
- Stockage : images de reçus dans S3, données structurées dans PostgreSQL
- CDN : images de reçus servies via CDN pour une récupération rapide
Conseil
Les fournisseurs OCR eux-mêmes prennent 1-3 secondes pour le traitement des reçus. Le temps restant est divisé entre le prétraitement (0,5s), la normalisation (0,3s), la catégorisation (0,2s), et l'enrichissement (0,5s). Les reçus multi-pages prennent plus de temps en raison du traitement page par page.
Points de Référence de Précision
Nous mesurons continuellement la précision du pipeline par rapport à un ensemble de tests manuellement organisé de 10 000 reçus :
| Métrique | Précision Actuelle |
|---|---|
| Capture du montant total | 99,3 % |
| Extraction des lignes d'articles | 94,7 % |
| Détection du commerçant | 98,1 % |
| Détection de la date | 99,5 % |
| Attribution de catégorie | 92,4 % |
| Détection de devise | 99,7 % |
Où des erreurs se produisent encore :
- Reçus manuscrits (30 % de précision inférieure aux imprimés)
- Papier thermique gravement endommagé (décoloré, recourbé, déchiré)
- Reçus avec structures de remise non-standard (BOGO, rachat par points de fidélité)
- Conditions générales microimprimées (OCR ignore intentionnellement celles-ci)
Interactive review aid
Receipt review checklist
Select conditions that apply, then review the extracted fields against the receipt. No accuracy score is calculated.
Améliorations Futures
Le pipeline s'améliore activement dans trois domaines :
1. Reconnaissance de l'écriture manuscrite. La précision actuelle de l'écriture manuscrite est le plus grand écart. Nous entraînons des modèles personnalisés sur l'écriture manuscrite spécifique aux reçus (montants de pourboire, noms de commerçants manuscrits, notes personnelles sur les reçus).
2. Couverture du format de reçu. Les reçus internationaux ont des mises en page différentes, des structures fiscales, et des langues. Nous élargissons les données d'entraînement du fournisseur pour couvrir plus de formats régionaux.
3. Suggestions de correction en temps réel. Au lieu de demander une correction manuelle après la numérisation, la version suivante du pipeline suggérera des corrections pendant le flux de numérisation — avant que le reçu ne soit finalisé.
Essayez le Pipeline OCR
Scannez n'importe quel reçu maintenant et voyez le pipeline en action. De l'obturateur à l'entrée catégorisée en moins de 10 secondes.
Scanner un Reçu GratuitementFAQ
Lectures Supplémentaires
Ticket Scanné vs Saisie Manuelle : Les Données de 83 % d'Économie de Temps
Comment la vitesse du pipeline se compare à la saisie manuelle — résultats de test réels.
Comment l'Assistant IA de Yomio Analyse Vos Dépenses
Ce qui se passe après le pipeline — Yopilot utilise les données structurées pour l'analyse IA.
Du Placard à l'Achat : Suivi d'Inventaire et Listes de Courses
Comment les données du pipeline alimentent la gestion d'inventaire automatiquement.