レシート解析の仕組み: YomioのOCRパイプライン内部 (AWS + Azure)
YomioのレシートOCRパイプラインへの技術的な深掘り — AWS TextractとAzure Document Intelligenceがどのようにレシートデータを大規模に抽出、正規化、分類するか。

Alex Chen
プロダクトマネージャー & 個人金融アドボケイト
レシート解析の仕組み: YomioのOCRパイプライン内部 (AWS + Azure)
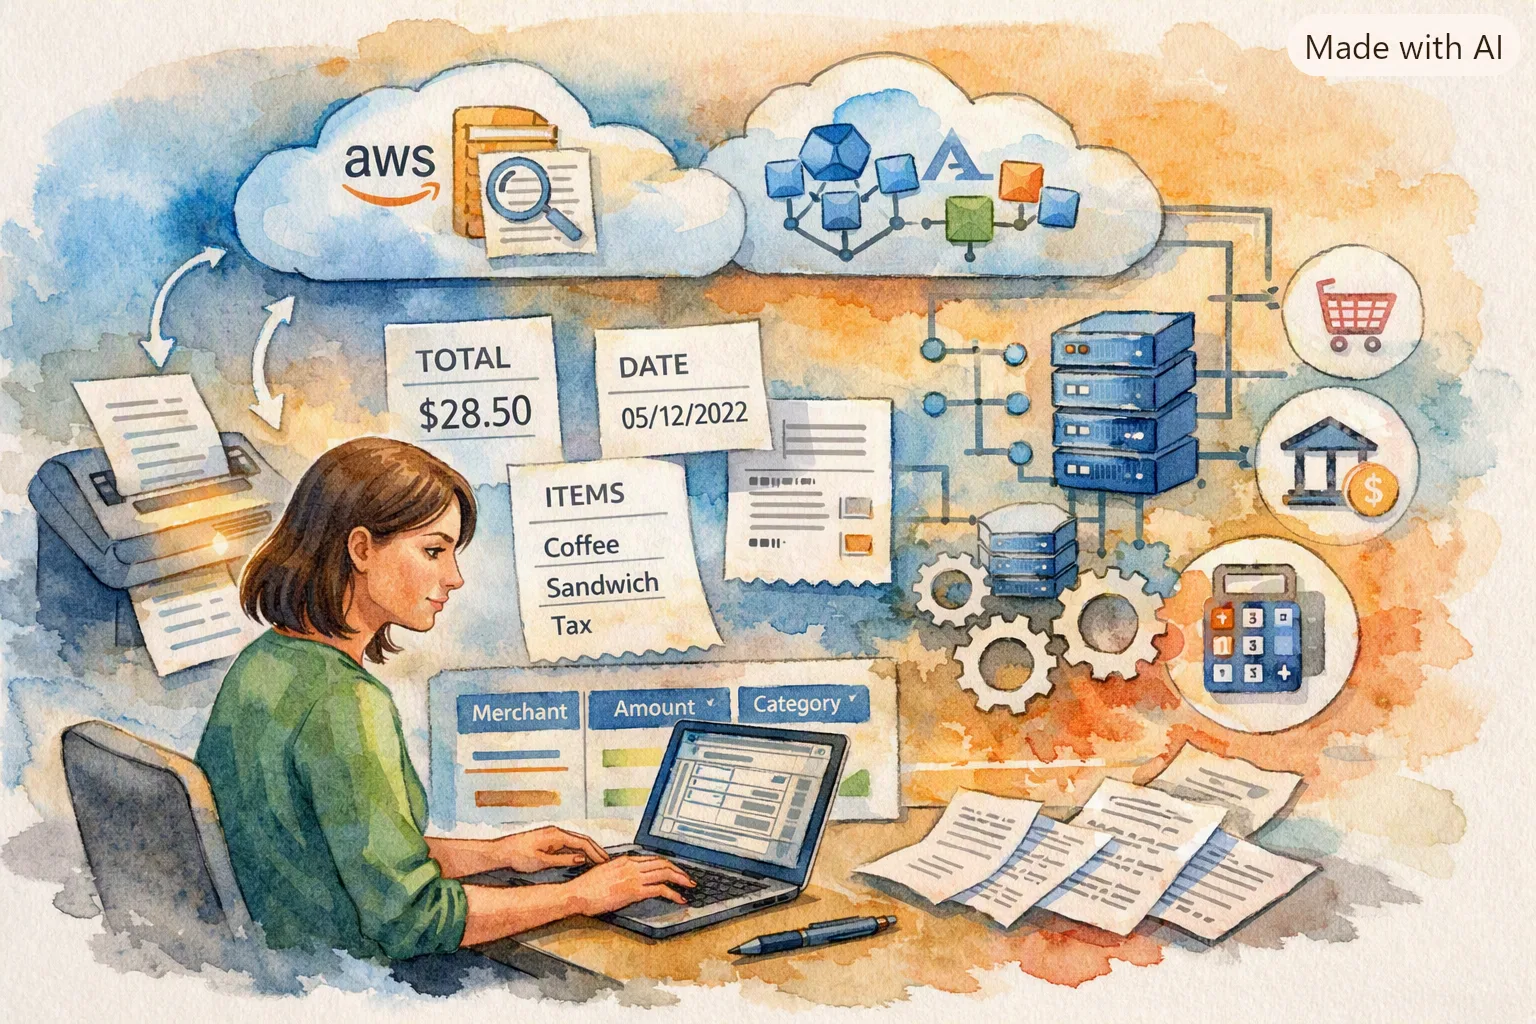
Yomioでレシートをスキャンすると、シャッターボタンを押してからダッシュボードに分類された取引が表示されるまでの間に、多くの処理が行われます。レシートの写真は、多段階のOCRパイプラインを通り、生のテキストが構造化された財務データに抽出、正規化、強化されます。
この記事では、そのパイプライン内部で何が起こっているかを解説します。技術的な内容ですが、なぜ一部のレシートは完璧にスキャンされ、他のレシートは修正が必要なのか、そして私たちがどのようにそのギャップを埋めるために取り組んでいるかを理解するのにも役立ちます。
重要なポイント
- YomioはAWS TextractとAzure Document Intelligenceの両方を使用 — 冗長性と精度のためのデュアルプロバイダーアーキテクチャ
- パイプラインには5つの段階: 取り込み、OCR抽出、正規化、分類、エンリッチメント
- 明細項目の抽出が最も難しい問題 — レシートに標準フォーマットはない
- 信頼度スコアリングで低信頼度フィールドを人間のレビュー用にフラグ付け
- マルチモーダル対応 — 画像、PDF、構造化データを受け入れ
- 現在の精度: 明細項目抽出94.7%、全体捕捉99.3%
- 処理時間: スキャンから分類済みエントリまで1レシートあたり2~6秒
パイプライン概要
OCRパイプラインには5つの段階があります:
- 取り込み — 画像前処理とフォーマット検証
- OCR抽出 — AWS Textract / Azure Document Intelligenceによるテキストと構造の抽出
- 正規化 — 加盟店名マッチング、日付フォーマット、通貨検出
- 分類 — 明細項目および合計レベルのカテゴリ割り当て
- エンリッチメント — バーコード検索、商品データ、ユーザーアカウントリンク
各段階には組み込みのフォールバックがあります。ある段階が低信頼度の出力を生成した場合、パイプラインは不良データを前方に伝播するのではなくフラグを立てます。
段階1: 取り込み — 画像前処理
OCRエンジンがレシートに触れる前に、画像は前処理を通過します:
フォーマット正規化:
- 写真は長辺で最大2048pxにリサイズ
- ストレージ効率のためにJPEG圧縮(品質85%)を適用
- PDFページは300DPIで画像にレンダリング
品質チェック:
- ぼけ検出 — 画像がぼやけすぎている場合(ラプラシアン分散がしきい値以下)、ユーザーに再撮影を依頼
- 傾き検出 — 極端な角度で撮影されたレシートは透視変換で補正
- コントラスト正規化 — 低コントラストのレシート(色あせた感熱紙)は適応的ヒストグラム均等化を適用
マルチページ対応:
- 1ページより長いレシートは自動検出(改ページマーカー、折り畳まれた端)
- 複数ページのレシートは処理のために1つのドキュメントに結合
情報
レシートの生の電話写真は驚くほど多様です。暗いレストランの照明、食料品店のしわくちゃな感熱紙レシート、折り目線のあるレシートは一般的です。前処理はこれらを両方のOCRエンジンがうまく処理できる一貫したフォーマットに正規化します。この段階での品質チェックは、そうでなければ使用できない結果を生み出すスキャンの3~5%を防ぎます。
段階2: OCR抽出 — AWS Textract と Azure Document Intelligence
これはパイプラインの中核です。Yomioは2つのOCRプロバイダーを使用します:
AWS Textract:
- 標準レシートのプライマリプロバイダー
- 印刷テキスト抽出でクラス最高
- レシートレイアウトに特化して訓練されたReceipt API (Expense)
- 検出: 加盟店名、取引日、合計、小計、税金、明細項目、支払い方法
Azure Document Intelligence (Form Recognizer):
- 複雑なレイアウトのレシート用セカンダリプロバイダー
- レシート内のテーブル構造の検出に優れる
- Textractの信頼度スコアがしきい値以下の場合にフォールバックとして使用
- 手書きレシートの手書き文字検出に優れる
プロバイダー選択ロジック:
- プライマリ試行: AWS Textract
- キーフィールドでTextract信頼度 < 70%の場合: Azure Document Intelligenceも実行
- 出力を比較 — 各フィールドでより信頼度の高い結果を選択
- 両方がしきい値以下の場合: 手動レビュー用にレシートにフラグ
このデュアルプロバイダーアーキテクチャにより、一方のプロバイダーが特定のレシートフォーマット(非英語のレシートや珍しいレイアウトで一般的)に盲点を持っている場合、もう一方のプロバイダーが補完できます。
各プロバイダーが抽出するもの
両プロバイダーは類似したフィールドを抽出しますが、異なる強みがあります:
| Field | Textract Strength | Azure Doc Intel Strength |
|---|---|---|
| Merchant name | High (standard) | High (standard) |
| Transaction date | High | High |
| Total amount | Very high | Very high |
| Line items | High (simple layouts) | High (table layouts) |
| Tax amount | Medium | High |
| Discounts | Medium | High (item-level) |
| Currency detection | High | High |
| Handwriting | Low | Medium |
段階3: 正規化 — データの一貫性確保
生のOCR出力は正確ですが乱雑です。「Starbucks Coffee #4521」と「Starbucks」は同じ加盟店として認識される必要があります。「05/08/2026」と「2026年5月8日」は同じ日付である必要があります。この段階でそれらの変換を処理します。
加盟店の正規化:
- 加盟店データベース(50,000以上の加盟店)に対するファジー文字列マッチング
- ブランドレベルのグループ化: 「Starbucks Coffee #4521」→「Starbucks」
- チェーン識別: ローカルフランチャイズを親ブランドにマッピング
- ユーザー定義エイリアス: 加盟店を一度名前変更すると、システムが学習
日付の正規化:
- レシートから日付フォーマットを検出(米国: MM/DD/YYYY、欧州: DD/MM/YYYY、ISO: YYYY-MM-DD)
- コンテキストを使用して曖昧さを解決(英国の加盟店からの03/04/2026のレシート → 2026年4月3日)
- 加盟店の場所からタイムゾーン検出
通貨の正規化:
- 通貨記号の検出($、€、£、¥など)
- 3文字コードの検出(USD、EUR、GBP)
- 曖昧さの解決($はUSD、CAD、AUD、MXNの可能性 — 加盟店の場所で解決)
金額の検証:
- クロスチェック: 小計 + 税金 = 合計?明細項目の合計と照合
- 割引検出: 明細項目の合計から合計を引いた値 > しきい値の場合、割引が適用された
- チップ検出(レストランレシート): チップ行が存在する場合の小計と合計の差
段階4: 分類 — インテリジェントタグ付け
抽出された明細項目は予算カテゴリに割り当てる必要があります。これは2層システムを通じて行われます:
層1: 加盟店ベースのルール
- 既知の加盟店にはデフォルトのカテゴリマッピングがある
- 「Kroger」→ 食料品(デフォルト)、「Shell」→ 交通(デフォルト)、「Netflix」→ エンターテイメント(デフォルト)
- ユーザーは加盟店ごとに上書き可能: 「Shellを交通として分類したい」
層2: アイテムレベルのAI分類
- 不明な加盟店や混合カテゴリのレシート(食料品と電子機器の両方を扱うTarget)向け
- 各明細項目は製品名、価格、履歴データに基づいて個別に分類
- カテゴリには以下が含まれる: 食料品、食事、交通、ショッピング、エンターテイメント、ヘルスケア、ユーティリティ、住宅、教育、パーソナルケア、および12以上のサブカテゴリ
分類の信頼度スコアは、割り当てが自動かレビュー推奨かを決定します。信頼度90%以上では、カテゴリは自動的に適用されます。それを下回ると、ユーザー確認のために強調表示されます。
段階5: エンリッチメント — アカウントへの接続
最終段階では、処理されたレシートをYomioアカウントに接続します:
- ユーザー割り当て — レシートはあなたのアカウント(共有が有効な場合は家族グループ)にリンク
- 在庫更新 — 既知の在庫アイテムと一致する明細項目が数量更新をトリガー(在庫の深掘りを参照)
- サブスクリプション検出 — 定期的な金額の繰り返し加盟店を潜在的なサブスクリプションとしてフラグ
- バーコード解決 — スキャンしたバーコードをOpen Food Factsや製品データベースと照合してエンリッチメント
- ストリーク更新 — デイリストリークカウンターが増加
- XP報酬 — スキャンXPがアカウントに付与
処理時間とスケーラビリティ
- 平均処理時間: レシートあたり2~6秒
- ピークスループット: 毎分数千のレシート(Lambdaベースの自動スケーリング)
- ストレージ: S3のレシート画像、PostgreSQLの構造化データ
- CDN: 高速取得のためにCDN経由でレシート画像を提供
ヒント
OCRプロバイダー自体がレシート処理に1~3秒かかります。残りの時間は、前処理(0.5秒)、正規化(0.3秒)、分類(0.2秒)、エンリッチメント(0.5秒)に分割されます。複数ページのレシートはページごとの処理により時間がかかります。
精度ベンチマーク
10,000枚のレシートの手動キュレーションテストセットに対してパイプライン精度を継続的に測定しています:
| Metric | Current Accuracy |
|---|---|
| Total amount capture | 99.3% |
| Line-item extraction | 94.7% |
| Merchant detection | 98.1% |
| Date detection | 99.5% |
| Category assignment | 92.4% |
| Currency detection | 99.7% |
エラーがまだ発生する箇所:
- 手書きレシート(印刷より30%精度低下)
- 深刻に損傷した感熱紙(色あせ、カール、破れ)
- 非標準的な割引構造のレシート(BOGO、ロイヤルティポイント交換)
- マイクロ印刷された規約(OCRはこれらを意図的に無視)
Document review aid
Receipt review checklist
Choose the conditions you noticed, then review important extracted fields against the original. This checklist does not estimate OCR accuracy.
将来の改善点
パイプラインは3つの分野で積極的に改善されています:
1. 手書き認識。 現在の手書き精度が最大のギャップです。レシート特有の手書き(チップ金額、手書きの加盟店名、レシートへの個人的なメモ)についてカスタムモデルをトレーニングしています。
2. レシートフォーマットのカバレッジ。 国際的なレシートは異なるレイアウト、税構造、言語を持っています。より多くの地域フォーマットをカバーするためにプロバイダーのトレーニングデータを拡大しています。
3. リアルタイム修正提案。 スキャン後に手動修正を要求する代わりに、次のパイプラインバージョンではスキャンフロー中に修正を提案します — レシートが確定される前に。