Jak funguje zpracování účtenek: Uvnitř OCR pipeliny Yomio (AWS + Azure)
Technický ponor do OCR pipeliny pro účtenky Yomio — jak AWS Textract a Azure Document Intelligence extrahují, normalizují a kategorizují data z účtenek ve velkém měřítku.

Alex Chen
Produktový manažer a obhájce osobních financí
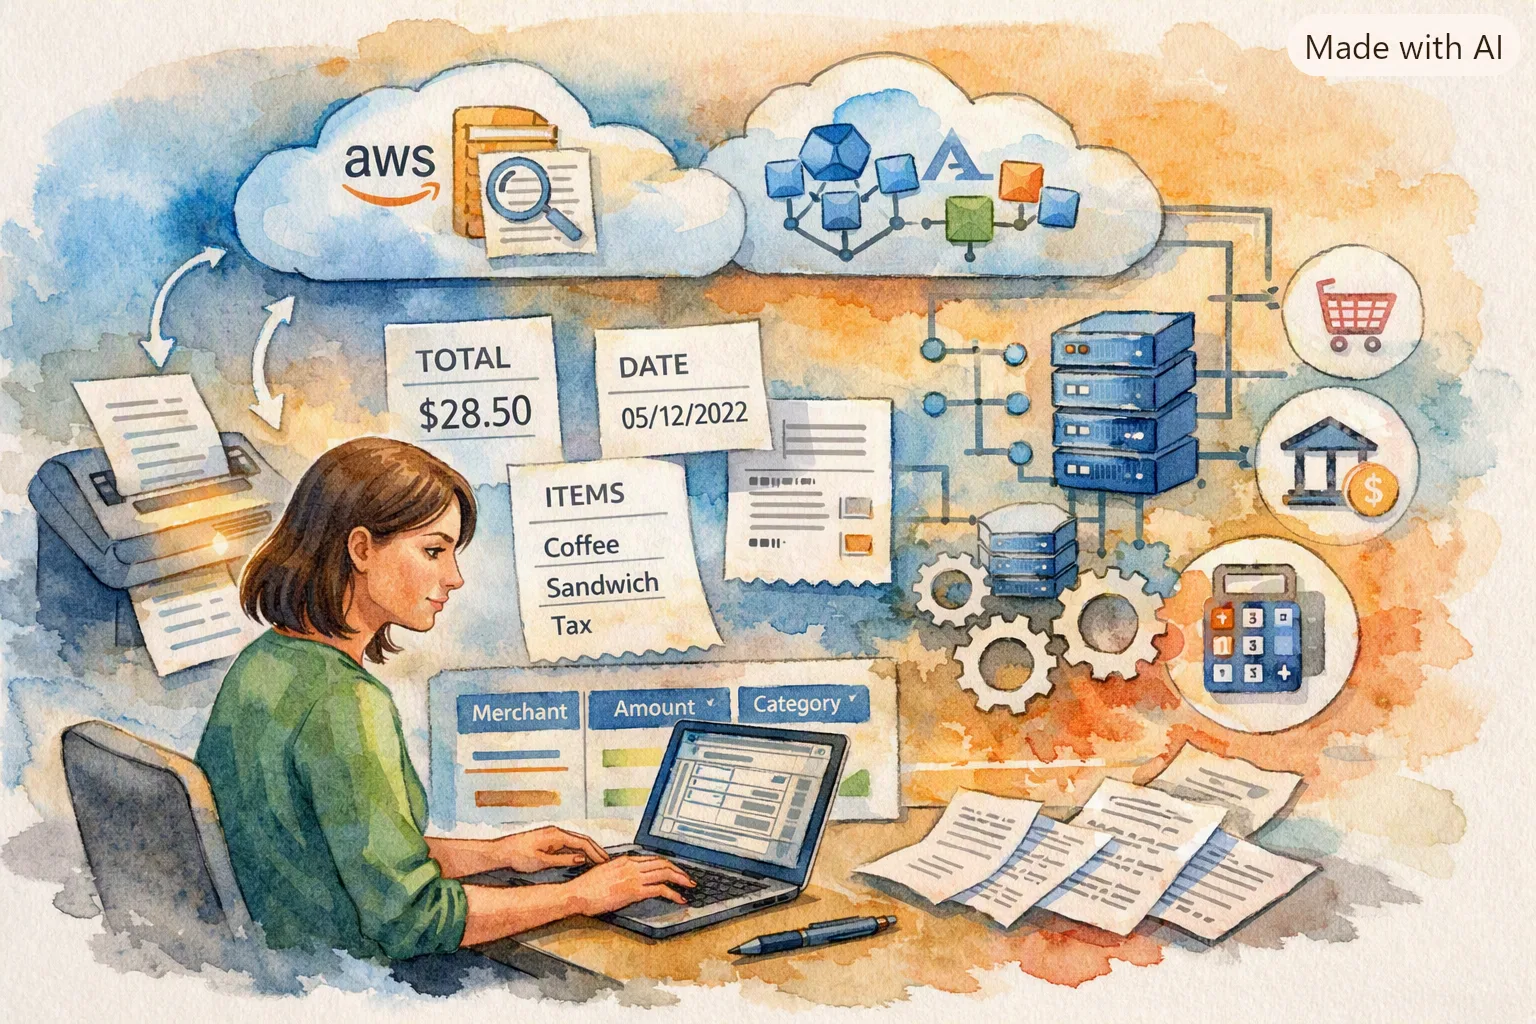
Jak funguje zpracování účtenek: Uvnitř OCR pipeliny Yomio (AWS + Azure)
Když naskenujete účtenku v Yomio, děje se mnoho věcí mezi stisknutím spouště a zobrazením kategorizované transakce na vašem dashboardu. Vaše fotografie účtenky putuje přes vícefázovou OCR pipelinu, která extrahuje, normalizuje a obohacuje surový text na strukturovaná finanční data.
Tento článek prochází tím, co se uvnitř této pipeliny děje. Je technický — ale také užitečný pro pochopení, proč se některé účtenky skenují dokonale a jiné vyžadují opravy, a jak pracujeme na překlenutí této mezery.
Klíčové poznatky
- Yomio používá jak AWS Textract, tak Azure Document Intelligence — architektura s dvěma poskytovateli pro redundanci a přesnost
- Pipelina má 5 fází: ingest, OCR extrakce, normalizace, kategorizace, obohacení
- Extrakce řádkových položek je nejtěžší problém — účtenky nemají standardní formát
- Skóre spolehlivosti označuje pole s nízkou spolehlivostí pro lidskou kontrolu
- Multimodální podpora — přijímá obrázky, PDF a strukturovaná data
- Aktuální přesnost: 94,7 % extrakce řádkových položek, 99,3 % celkového zachycení
- Doba zpracování: 2–6 sekund na účtenku od skenování po kategorizovaný záznam
Přehled pipeliny
OCR pipelina má pět fází:
- Ingest — předzpracování obrazu a validace formátu
- OCR extrakce — extrakce textu a struktury pomocí AWS Textract / Azure Document Intelligence
- Normalizace — párování názvu obchodníka, formátování data, detekce měny
- Kategorizace — přiřazení kategorie na úrovni položky a celkové částky
- Obohacení — vyhledávání čárových kódů, produktová data, propojení uživatelského účtu
Každá fáze má vestavěné záložní mechanismy. Pokud fáze produkuje výstup s nízkou spolehlivostí, pipelina to označí, místo aby šířila špatná data dále.
Fáze 1: Ingest — Předzpracování obrazu
Než se OCR enginy dotknou účtenky, obraz prochází předzpracováním:
Normalizace formátu:
- Fotografie se změní na maximálně 2048px na nejdelší straně
- Pro efektivitu ukládání se použije JPEG komprese (kvalita 85 %)
- Stránky PDF se vykreslí jako obrázky při 300 DPI
Kontrola kvality:
- Detekce rozmazání — pokud je obraz příliš rozmazaný (Laplaciánská variance pod prahem), uživatel je požádán o nové focení
- Detekce zkosení — účtenky focené v extrémních úhlech jsou opraveny perspektivní transformací
- Normalizace kontrastu — účtenky s nízkým kontrastem (vybledlý termální papír) získají adaptivní vyrovnání histogramu
Podpora více stránek:
- Účtenky delší než jedna stránka jsou automaticky detekovány (značky konce stránky, přehnuté okraje)
- Vícestránkové účtenky jsou spojeny do jednoho dokumentu pro zpracování
Informace
Surové telefonní fotografie účtenek jsou překvapivě proměnlivé. Běžné jsou tmavé osvětlení v restauracích, pomačkané účtenky z termálního papíru z obchodů s potravinami a účtenky s liniemi přehybu. Předzpracování je normalizuje do konzistentního formátu, který oba OCR enginy dobře zpracovávají. Kontroly kvality v této fázi zabrání 3–5 % skenů, které by jinak produkovaly nepoužitelné výsledky.
Fáze 2: OCR extrakce — AWS Textract a Azure Document Intelligence
Toto je jádro pipeliny. Yomio používá dva poskytovatele OCR:
AWS Textract:
- Primární poskytovatel pro standardní účtenky
- Nejlepší ve své třídě pro extrakci tištěného textu
- Receipt API (Expense) speciálně trénované na rozvržení účtenek
- Detekuje: název obchodníka, datum transakce, celkovou částku, mezisoučet, daň, řádkové položky, způsob platby
Azure Document Intelligence (Form Recognizer):
- Sekundární poskytovatel pro účtenky se složitým rozvržením
- Lepší detekce tabulkových struktur v účtenkách
- Používá se jako záložní, když je skóre spolehlivosti Textract pod prahem
- Lepší detekce rukopisu pro ručně psané účtenky
Logika výběru poskytovatele:
- Primární pokus: AWS Textract
- Pokud je spolehlivost Textract < 70 % u klíčových polí: spustit také Azure Document Intelligence
- Porovnat výstupy — vybrat výsledek s vyšší spolehlivostí pro každé pole
- Pokud jsou oba pod prahem: označit účtenku pro manuální kontrolu
Tato architektura s dvěma poskytovateli znamená, že pokud má jeden poskytovatel slepé místo pro určitý formát účtenky (běžné u neanglických účtenek nebo neobvyklých rozvržení), druhý poskytovatel to může kompenzovat.
Co každý poskytovatel extrahuje
Oba poskytovatelé extrahují podobná pole, ale s různými silnými stránkami:
| Field | Textract Strength | Azure Doc Intel Strength |
|---|---|---|
| Merchant name | High (standard) | High (standard) |
| Transaction date | High | High |
| Total amount | Very high | Very high |
| Line items | High (simple layouts) | High (table layouts) |
| Tax amount | Medium | High |
| Discounts | Medium | High (item-level) |
| Currency detection | High | High |
| Handwriting | Low | Medium |
Fáze 3: Normalizace — Zajištění konzistence dat
Surový OCR výstup je přesný, ale neuspořádaný. "Starbucks Coffee #4521" a "Starbucks" musí být rozpoznány jako stejný obchodník. "05/08/2026" a "8. května 2026" musí být stejné datum. Tato fáze se stará o tyto transformace.
Normalizace obchodníka:
- Fuzzy porovnávání řetězců proti databázi obchodníků (přes 50 000 obchodníků)
- Seskupování na úrovni značky: "Starbucks Coffee #4521" → "Starbucks"
- Identifikace řetězce: místní franšízy mapované na jejich mateřskou značku
- Uživatelsky definované aliasy: pokud přejmenujete obchodníka jednou, systém se to naučí
Normalizace data:
- Detekuje formát data z účtenky (US: MM/DD/YYYY, EU: DD/MM/YYYY, ISO: YYYY-MM-DD)
- Řeší nejednoznačnost pomocí kontextu (účtenka od britského obchodníka 03/04/2026 → 3. dubna 2026)
- Detekce časového pásma podle lokality obchodníka
Normalizace měny:
- Detekce symbolů měny ($, €, £, ¥, atd.)
- Detekce třímístného kódu (USD, EUR, GBP)
- Řešení nejednoznačnosti ($ může být USD, CAD, AUD, MXN — vyřešeno podle lokality obchodníka)
Validace částky:
- Křížové kontroly: mezisoučet + daň = celkem? Ověřeno proti součtu řádkových položek
- Detekce slevy: pokud součet řádkových položek minus celkem > práh, byla uplatněna sleva
- Detekce spropitného (restaurační účtenky): rozdíl mezi mezisoučtem a celkem, pokud existuje řádek pro spropitné
Fáze 4: Kategorizace — Inteligentní tagování
Extrahované řádkové položky musí být přiřazeny do rozpočtových kategorií. To probíhá prostřednictvím dvouvrstvého systému:
Vrstva 1: Pravidla založená na obchodníkovi
- Známí obchodníci mají výchozí mapování kategorií
- "Kroger" → Potraviny (výchozí), "Shell" → Doprava (výchozí), "Netflix" → Zábava (výchozí)
- Uživatelé mohou přepsat na úrovni obchodníka: "Chci, aby Shell byl kategorizován jako Doprava"
Vrstva 2: AI kategorizace na úrovni položky
- Pro neznámé obchodníky nebo účtenky se smíšenými kategoriemi (Target s potravinami i elektronikou)
- Každá řádková položka je kategorizována samostatně na základě názvu produktu, ceny a historických dat
- Kategorie zahrnují: Potraviny, Stravování, Doprava, Nakupování, Zábava, Zdravotní péče, Služby, Bydlení, Vzdělání, Osobní péče a 12+ podkategorií
Skóre spolehlivosti kategorizace určuje, zda je přiřazení automatické nebo navržené ke kontrole. Při spolehlivosti 90 %+ je kategorie aplikována tiše. Pod touto hranicí je zvýrazněna pro potvrzení uživatelem.
Fáze 5: Obohacení — Propojení s vaším účtem
Poslední fáze propojuje zpracovanou účtenku s vaším Yomio účtem:
- Přiřazení uživatele — účtenka je propojena s vaším účtem (nebo rodinnou skupinou, pokud je sdílení povoleno)
- Aktualizace zásob — řádkové položky odpovídající známým položkám zásob spouštějí aktualizace množství (viz náš ponor do zásob)
- Detekce předplatného — opakující se obchodníci s pravidelnými částkami jsou označeni jako potenciální předplatná
- Rozlišení čárového kódu — naskenované čárové kódy jsou porovnány s Open Food Facts a produktovými databázemi pro obohacení
- Aktualizace série — denní počítadlo sérií se zvyšuje
- XP odměna — skenovací XP je připsáno na váš účet
Doba zpracování a škálovatelnost
- Průměrná doba zpracování: 2–6 sekund na účtenku
- Špičková propustnost: tisíce účtenek za minutu (automatické škálování na bázi Lambda)
- Úložiště: obrázky účtenek v S3, strukturovaná data v PostgreSQL
- CDN: obrázky účtenek doručovány přes CDN pro rychlé načtení
Tip
Samotní poskytovatelé OCR potřebují 1–3 sekundy na zpracování účtenky. Zbývající čas je rozdělen mezi předzpracování (0,5 s), normalizaci (0,3 s), kategorizaci (0,2 s) a obohacení (0,5 s). Vícestránkové účtenky trvají déle kvůli zpracování stránku po stránce.
Srovnávací přehledy přesnosti
Průběžně měříme přesnost pipeliny proti ručně sestavené testovací sadě 10 000 účtenek:
| Metric | Current Accuracy |
|---|---|
| Total amount capture | 99,3 % |
| Line-item extraction | 94,7 % |
| Merchant detection | 98,1 % |
| Date detection | 99,5 % |
| Category assignment | 92,4 % |
| Currency detection | 99,7 % |
Kde stále dochází k chybám:
- Ručně psané účtenky (o 30 % nižší přesnost než tištěné)
- Silně poškozený termální papír (vybledlý, zkroucený, roztržený)
- Účtenky s nestandardními slevovými strukturami (BOGO, uplatnění věrnostních bodů)
- Mikrotištěné obchodní podmínky (OCR je záměrně ignoruje)
Document review aid
Receipt review checklist
Choose the conditions you noticed, then review important extracted fields against the original. This checklist does not estimate OCR accuracy.
Budoucí vylepšení
Pipelina se aktivně zlepšuje ve třech oblastech:
1. Rozpoznávání rukopisu. Současná přesnost rukopisu je největší mezera. Trénujeme vlastní modely na rukopis specifický pro účtenky (částky spropitného, ručně psané názvy obchodníků, osobní poznámky na účtenkách).
2. Pokrytí formátů účtenek. Mezinárodní účtenky mají různá rozvržení, daňové struktury a jazyky. Rozšiřujeme trénovací data poskytovatelů, aby pokryla více regionálních formátů.
3. Návrhy oprav v reálném čase. Místo vyžadování manuální opravy po skenování bude další verze pipeliny navrhovat opravy během toku skenování — před dokončením účtenky.
Vyzkoušejte OCR pipelinu
Naskenujte jakoukoli účtenku právě teď a uvidíte pipelinu v akci. Od spouště po kategorizovaný záznam za méně než 10 sekund.
Skenovat účtenku zdarmaČasto kladené otázky
Další čtení
Skenování účtenek vs. ruční zadávání: 83% úspora času
Jak se rychlost pipeliny srovnává s ručním zadáváním — skutečné výsledky testů.
Jak Yomio AI Copilot analyzuje vaše výdaje
Co se děje po pipelině — Yopilot používá strukturovaná data pro AI analýzu.
Ze spíže k nákupu: Sledování zásob a nákupních seznamů
Jak data z pipeliny automaticky napájejí správu zásob.