Wie funktioniert die Beleganalyse? Ein Blick in Yomios OCR-Pipeline (AWS + Azure)
Ein technischer Tiefgang in Yomios OCR-Pipeline für Belege – wie AWS Textract und Azure Document Intelligence Belegdaten in großem Maßstab extrahieren, normalisieren und kategorisieren.

Alex Chen
Produktmanager & Fürsprecher für persönliche Finanzen
Wie funktioniert die Beleganalyse? Ein Blick in Yomios OCR-Pipeline (AWS + Azure)
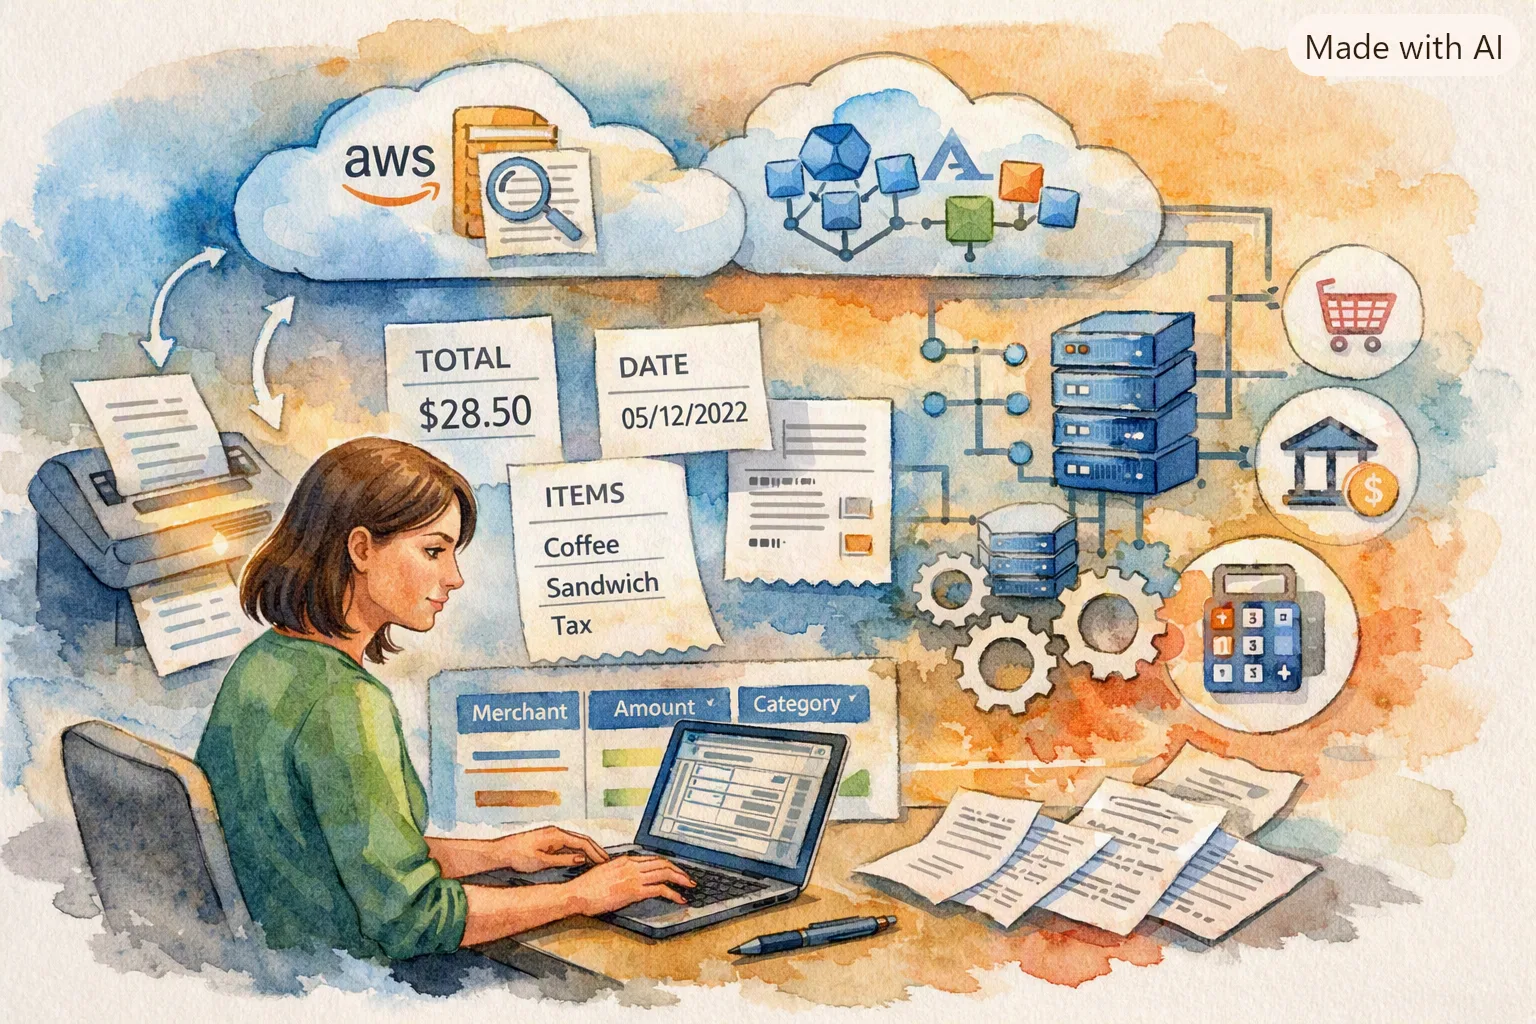
Wenn du einen Beleg in Yomio scannst, passiert eine Menge zwischen dem Drücken des Auslösers und dem Anzeigen der kategorisierten Transaktion in deinem Dashboard. Dein Belegfoto durchläuft eine mehrstufige OCR-Pipeline, die den Rohtext extrahiert, normalisiert und in strukturierte Finanzdaten anreichert.
Dieser Artikel führt durch das, was in dieser Pipeline passiert. Er ist technisch – aber auch nützlich, um zu verstehen, warum einige Belege perfekt gescannt werden und andere Korrekturen benötigen, und wie wir daran arbeiten, diese Lücke zu schließen.
Wichtige Erkenntnisse
- Yomio verwendet sowohl AWS Textract als auch Azure Document Intelligence – Dual-Provider-Architektur für Redundanz und Genauigkeit
- Pipeline hat 5 Stufen: Erfassung, OCR-Extraktion, Normalisierung, Kategorisierung, Anreicherung
- Positionenextraktion ist das schwierigste Problem – Belege haben kein Standardformat
- Konfidenzbewertung markiert Felder mit niedriger Konfidenz für manuelle Überprüfung
- Multimodale Unterstützung – nimmt Bilder, PDFs und strukturierte Daten entgegen
- Aktuelle Genauigkeit: 94,7 % Positionenextraktion, 99,3 % Gesamterfassung
- Verarbeitungszeit: 2–6 Sekunden pro Beleg vom Scan bis zum kategorisierten Eintrag
Pipeline-Übersicht
Die OCR-Pipeline besteht aus fünf Stufen:
- Erfassung – Bildvorverarbeitung und Formatvalidierung
- OCR-Extraktion – Text- und Strukturextraktion über AWS Textract / Azure Document Intelligence
- Normalisierung – Händlernamensabgleich, Datumsformatierung, Währungserkennung
- Kategorisierung – Kategorienzuweisung auf Positionsebene und Gesamtebene
- Anreicherung – Barcode-Nachschlag, Produktdaten, Benutzerkontenverknüpfung
Jede Stufe hat eingebaute Fallbacks. Wenn eine Stufe eine Ausgabe mit niedriger Konfidenz produziert, markiert die Pipeline dies, anstatt schlechte Daten weiterzuleiten.
Stufe 1: Erfassung – Bildvorverarbeitung
Bevor OCR-Engines den Beleg berühren, durchläuft das Bild eine Vorverarbeitung:
Formatnormalisierung:
- Fotos werden auf maximal 2048px an der längsten Kante skaliert
- JPEG-Komprimierung wird angewendet (Qualität 85 %) für Speichereffizienz
- PDF-Seiten werden mit 300 DPI als Bilder gerendert
Qualitätsprüfungen:
- Unschärfeerkennung – wenn das Bild zu unscharf ist (Laplacian-Varianz unter Schwellenwert), wird der Benutzer aufgefordert, es erneut aufzunehmen
- Schrägstellungserkennung – Belege, die in extremen Winkeln aufgenommen wurden, werden durch Perspektivtransformation korrigiert
- Kontrastnormalisierung – Belege mit niedrigem Kontrast (verblasstes Thermopapier) erhalten eine adaptive Histogrammentzerrung
Mehrseitenunterstützung:
- Belege, die länger als eine Seite sind, werden automatisch erkannt (Seitenwechselmarkierungen, gefaltete Kanten)
- Mehrseitige Belege werden zu einem einzigen Dokument für die Verarbeitung zusammengefügt
Information
Rohfotos von Belegen sind überraschend variabel. Dunkle Restaurantbeleuchtung, zerknitterte Thermopapierbelege aus Supermärkten und Belege mit Falzlinien sind häufig. Die Vorverarbeitung normalisiert diese in ein einheitliches Format, das beide OCR-Engines gut verarbeiten. Die Qualitätsprüfungen in dieser Stufe verhindern die 3–5 % der Scans, die sonst unbrauchbare Ergebnisse liefern würden.
Stufe 2: OCR-Extraktion – AWS Textract und Azure Document Intelligence
Dies ist der Kern der Pipeline. Yomio verwendet zwei OCR-Anbieter:
AWS Textract:
- Primärer Anbieter für Standardbelege
- Branchenbeste Extraktion von gedrucktem Text
- Receipt API (Expense) speziell für Beleglayouts trainiert
- Erkennt: Händlername, Transaktionsdatum, Gesamtsumme, Zwischensumme, Steuer, Positionen, Zahlungsmethode
Azure Document Intelligence (Form Recognizer):
- Sekundärer Anbieter für Belege mit komplexen Layouts
- Besser geeignet zur Erkennung von Tabellenstrukturen in Belegen
- Wird als Fallback verwendet, wenn Textract-Konfidenzwerte unter dem Schwellenwert liegen
- Bessere Handschrifterkennung für handschriftliche Belege
Logik der Anbieterauswahl:
- Primärer Versuch: AWS Textract
- Wenn Textract-Konfidenz < 70 % bei Schlüsselfeldern: auch Azure Document Intelligence ausführen
- Ausgaben vergleichen – das Ergebnis mit der höheren Konfidenz für jedes Feld auswählen
- Wenn beide unter dem Schwellenwert: Beleg für manuelle Überprüfung markieren
Diese Dual-Provider-Architektur bedeutet, dass wenn ein Anbieter einen blinden Fleck für ein bestimmtes Belegformat hat (häufig bei nicht-englischen Belegen oder ungewöhnlichen Layouts), der andere Anbieter dies kompensieren kann.
Was jeder Anbieter extrahiert
Beide Anbieter extrahieren ähnliche Felder, jedoch mit unterschiedlichen Stärken:
| Field | Textract Strength | Azure Doc Intel Strength |
|---|---|---|
| Merchant name | High (standard) | High (standard) |
| Transaction date | High | High |
| Total amount | Very high | Very high |
| Line items | High (simple layouts) | High (table layouts) |
| Tax amount | Medium | High |
| Discounts | Medium | High (item-level) |
| Currency detection | High | High |
| Handwriting | Low | Medium |
Stufe 3: Normalisierung – Daten konsistent machen
Die rohe OCR-Ausgabe ist genau, aber chaotisch. "Starbucks Coffee #4521" und "Starbucks" müssen als derselbe Händler erkannt werden. "05/08/2026" und "8. Mai 2026" müssen dasselbe Datum sein. Diese Stufe übernimmt diese Transformationen.
Händlernormalisierung:
- Unscharfer String-Abgleich gegen eine Händlerdatenbank (über 50.000 Händler)
- Gruppierung auf Markenebene: "Starbucks Coffee #4521" → "Starbucks"
- Kettenidentifikation: lokale Franchises werden ihrer Muttermarke zugeordnet
- Benutzerdefinierte Aliase: wenn du einen Händler einmal umbenennst, lernt das System dies
Datumsnormalisierung:
- Erkennt das Datumsformat vom Beleg (US: MM/TT/JJJJ, EU: TT/MM/JJJJ, ISO: JJJJ-MM-TT)
- Löst Mehrdeutigkeiten durch Kontext (ein Beleg eines britischen Händlers vom 03/04/2026 → 3. April 2026)
- Zeitzonenerkennung vom Standort des Händlers
Währungsnormalisierung:
- Erkennung von Währungssymbolen ($, €, £, ¥, usw.)
- Drei-Buchstaben-Code-Erkennung (USD, EUR, GBP)
- Mehrdeutigkeitsauflösung ($ könnte USD, CAD, AUD, MXN sein – gelöst über Händlerstandort)
Betragsvalidierung:
- Gegenprüfungen: Zwischensumme + Steuer = Gesamtsumme? Gegen die Summe der Positionen verifiziert
- Rabatterkennung: wenn Positionssumme minus Gesamtsumme > Schwellenwert, wurde ein Rabatt gewährt
- Trinkgelderkennung (Restaurantbelege): Differenz zwischen Zwischensumme und Gesamtsumme, wenn eine Trinkgeldzeile vorhanden ist
Stufe 4: Kategorisierung – Intelligentes Tagging
Extrahierte Positionen müssen Budgetkategorien zugewiesen werden. Dies geschieht über ein zweischichtiges System:
Schicht 1: Händlerbasierte Regeln
- Bekannte Händler haben Standardkategoriezuordnungen
- "Kroger" → Lebensmittel (Standard), "Shell" → Transport (Standard), "Netflix" → Unterhaltung (Standard)
- Benutzer können pro Händler überschreiben: "Ich möchte Shell als Transport kategorisiert haben"
Schicht 2: KI-Kategorisierung auf Artikelebene
- Für unbekannte Händler oder Belege mit gemischten Kategorien (Target mit Lebensmitteln und Elektronik)
- Jede Position wird basierend auf Produktname, Preis und historischen Daten separat kategorisiert
- Kategorien umfassen: Lebensmittel, Essen, Transport, Einkaufen, Unterhaltung, Gesundheitswesen, Versorgung, Wohnen, Bildung, Körperpflege und 12+ Unterkategorien
Der Kategorisierungs-Konfidenzwert bestimmt, ob die Zuordnung automatisch oder zur Überprüfung vorgeschlagen wird. Bei 90 %+ Konfidenz wird die Kategorie stillschweigend angewendet. Darunter wird sie zur Benutzerbestätigung hervorgehoben.
Stufe 5: Anreicherung – Verbindung zu deinem Konto
Die letzte Stufe verbindet den verarbeiteten Beleg mit deinem Yomio-Konto:
- Benutzerzuweisung – der Beleg wird mit deinem Konto verknüpft (oder Familiengruppe, wenn Freigabe aktiviert ist)
- Bestandsaktualisierung – Positionen, die bekannten Bestandsartikeln entsprechen, lösen Mengenaktualisierungen aus (siehe unseren Bestands-Tiefgang)
- Abonnementerkennung – wiederkehrende Händler mit regelmäßigen Beträgen werden als potenzielle Abonnements markiert
- Barcode-Auflösung – gescannte Barcodes werden mit Open Food Facts und Produktdatenbanken zur Anreicherung abgeglichen
- Serienaktualisierung – der tägliche Serienzähler wird erhöht
- XP-Prämie – Scan-XP wird deinem Konto gutgeschrieben
Verarbeitungszeit und Skalierbarkeit
- Durchschnittliche Verarbeitungszeit: 2–6 Sekunden pro Beleg
- Spitzendurchsatz: Tausende von Belegen pro Minute (Lambda-basierte automatische Skalierung)
- Speicherung: Belegbilder in S3, strukturierte Daten in PostgreSQL
- CDN: Belegbilder werden über CDN für schnellen Abruf bereitgestellt
Tipp
Die OCR-Anbieter selbst benötigen 1–3 Sekunden für die Belegverarbeitung. Die verbleibende Zeit verteilt sich auf Vorverarbeitung (0,5 s), Normalisierung (0,3 s), Kategorisierung (0,2 s) und Anreicherung (0,5 s). Mehrseitige Belege dauern aufgrund der seitenweisen Verarbeitung länger.
Genauigkeitsbenchmarks
Wir messen kontinuierlich die Pipeline-Genauigkeit anhand eines manuell zusammengestellten Testsatzes von 10.000 Belegen:
| Metric | Current Accuracy |
|---|---|
| Total amount capture | 99,3 % |
| Line-item extraction | 94,7 % |
| Merchant detection | 98,1 % |
| Date detection | 99,5 % |
| Category assignment | 92,4 % |
| Currency detection | 99,7 % |
Wo noch Fehler auftreten:
- Handschriftliche Belege (30 % geringere Genauigkeit als gedruckte)
- Stark beschädigtes Thermopapier (verblasst, gewellt, zerrissen)
- Belege mit nicht standardmäßigen Rabattstrukturen (BOGO, Treuepunkteinlösungen)
- Mikrogedruckte Allgemeine Geschäftsbedingungen (OCR ignoriert diese bewusst)
Document review aid
Receipt review checklist
Choose the conditions you noticed, then review important extracted fields against the original. This checklist does not estimate OCR accuracy.
Zukünftige Verbesserungen
Die Pipeline wird aktiv in drei Bereichen verbessert:
1. Handschrifterkennung. Die aktuelle Handschriftgenauigkeit ist die größte Lücke. Wir trainieren benutzerdefinierte Modelle auf belegspezifische Handschrift (Trinkgeldbeträge, handschriftliche Händlernamen, persönliche Notizen auf Belegen).
2. Abdeckung von Belegformaten. Internationale Belege haben unterschiedliche Layouts, Steuerstrukturen und Sprachen. Wir erweitern die Trainingsdaten der Anbieter, um mehr regionale Formate abzudecken.
3. Echtzeit-Korrekturvorschläge. Anstatt manuelle Korrekturen nach dem Scannen zu erfordern, wird die nächste Pipeline-Version Korrekturen während des Scanvorgangs vorschlagen – bevor der Beleg finalisiert wird.
Teste die OCR-Pipeline
Scanne jetzt jeden Beleg und sieh die Pipeline in Aktion. Vom Auslöser zum kategorisierten Eintrag in unter 10 Sekunden.
Scanne einen Beleg kostenlosHäufig gestellte Fragen
Weiterführende Literatur
Belegscan vs. manuelle Eingabe: 83 % Zeitersparnis
Wie die Geschwindigkeit der Pipeline im Vergleich zur manuellen Eingabe abschneidet – echte Testergebnisse.
Wie Yomios KI-Copilot deine Ausgaben analysiert
Was nach der Pipeline passiert – Yopilot nutzt die strukturierten Daten für die KI-Analyse.
Von der Vorratskammer zum Kauf: Bestands- und Einkaufslistenverfolgung
Wie Pipelinedaten automatisch in die Bestandsverwaltung einfließen.