Cómo funciona el análisis de recibos: Dentro del pipeline OCR de Yomio (AWS + Azure)
Una inmersión técnica en el pipeline OCR de recibos de Yomio — cómo AWS Textract y Azure Document Intelligence extraen, normalizan y categorizan datos de recibos a escala.

Alex Chen
Gerente de Producto y Defensor de Finanzas Personales
Cómo funciona el análisis de recibos: Dentro del pipeline OCR de Yomio (AWS + Azure)
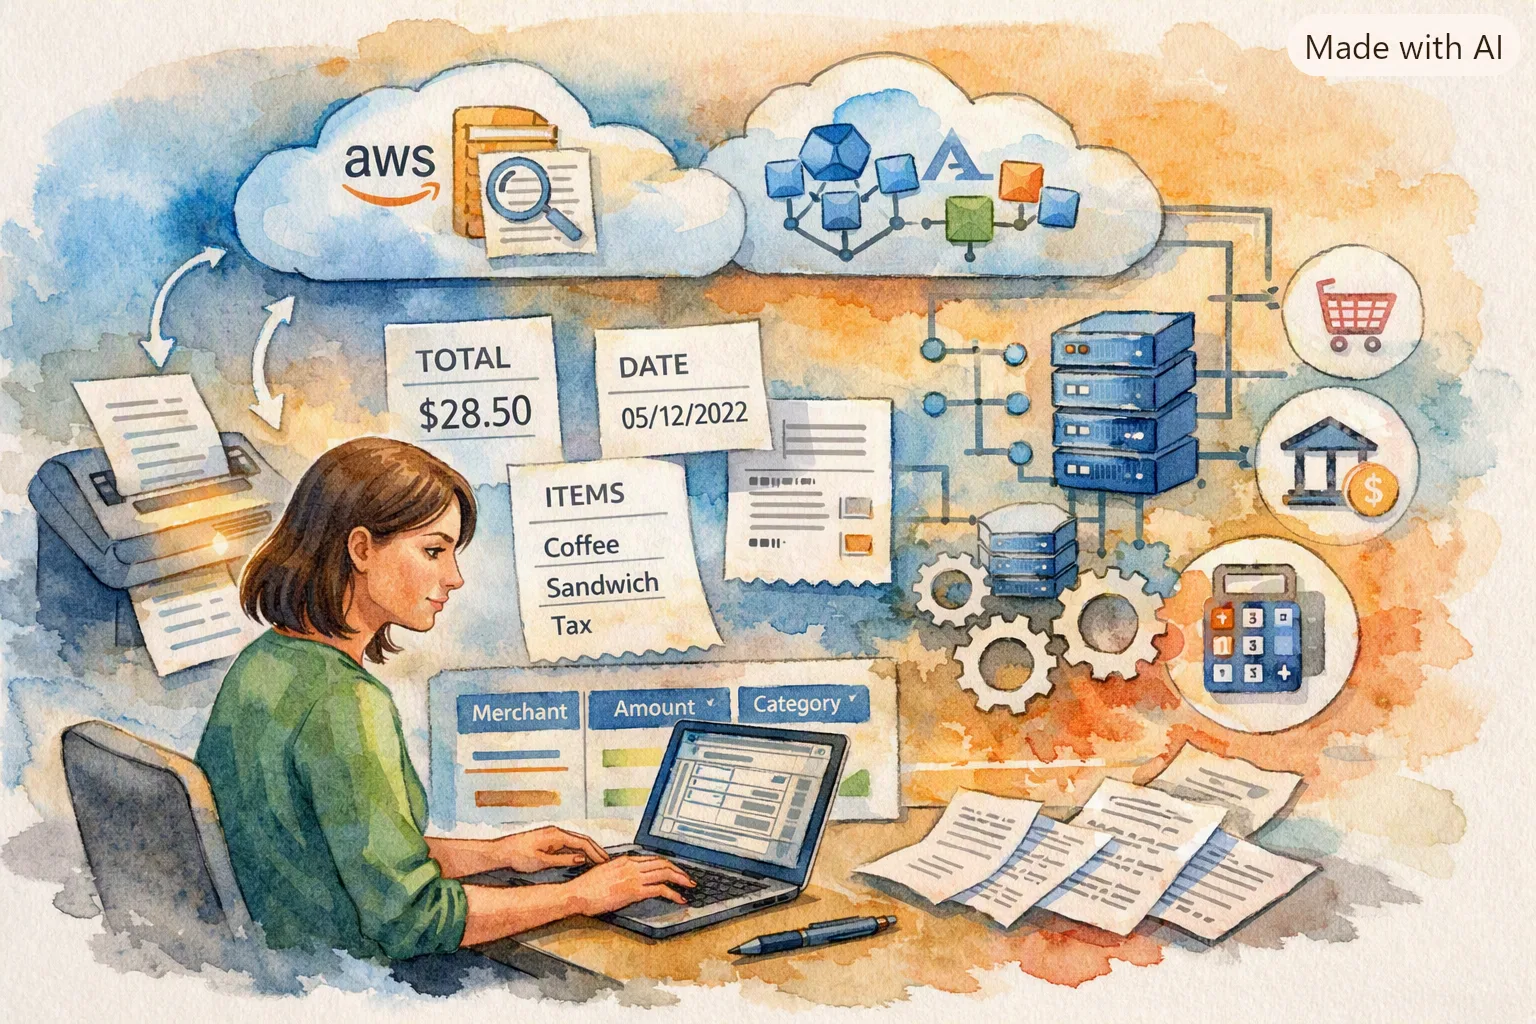
Cuando escaneas un recibo en Yomio, suceden muchas cosas entre presionar el botón del obturador y ver la transacción categorizada en tu panel. Tu foto del recibo viaja a través de un pipeline OCR de múltiples etapas que extrae, normaliza y enriquece el texto bruto en datos financieros estructurados.
Este artículo explica lo que sucede dentro de ese pipeline. Es técnico, pero también es útil para entender por qué algunos recibos se escanean perfectamente y otros necesitan correcciones, y cómo estamos trabajando para cerrar esa brecha.
Puntos clave
- Yomio utiliza tanto AWS Textract como Azure Document Intelligence — arquitectura de doble proveedor para redundancia y precisión
- El pipeline tiene 5 etapas: ingesta, extracción OCR, normalización, categorización, enriquecimiento
- La extracción de líneas de artículos es el problema más difícil — los recibos no tienen un formato estándar
- La puntuación de confianza marca los campos de baja confianza para revisión humana
- Soporte multimodal — recibe imágenes, PDF y datos estructurados
- Precisión actual: 94,7 % de extracción de líneas de artículos, 99,3 % de captura total
- Tiempo de procesamiento: 2–6 segundos por recibo desde el escaneo hasta la entrada categorizada
Descripción general del pipeline
El pipeline OCR tiene cinco etapas:
- Ingesta — preprocesamiento de imagen y validación de formato
- Extracción OCR — extracción de texto y estructura mediante AWS Textract / Azure Document Intelligence
- Normalización — coincidencia de nombre del comerciante, formato de fecha, detección de moneda
- Categorización — asignación de categoría a nivel de línea de artículo y total
- Enriquecimiento — consulta de código de barras, datos del producto, vinculación de cuenta de usuario
Cada etapa tiene respaldos incorporados. Si una etapa produce resultados de baja confianza, el pipeline lo marca en lugar de propagar datos incorrectos.
Etapa 1: Ingesta — Preprocesamiento de imagen
Antes de que los motores OCR toquen el recibo, la imagen pasa por un preprocesamiento:
Normalización de formato:
- Las fotos se redimensionan a un máximo de 2048px en el borde más largo
- Se aplica compresión JPEG (calidad 85 %) para eficiencia de almacenamiento
- Las páginas PDF se renderizan como imágenes a 300 DPI
Controles de calidad:
- Detección de desenfoque — si la imagen está demasiado borrosa (varianza laplaciana por debajo del umbral), se pide al usuario que vuelva a tomar la foto
- Detección de inclinación — los recibos tomados en ángulos extremos se corrigen mediante transformación de perspectiva
- Normalización de contraste — los recibos de bajo contraste (papel térmico descolorido) reciben ecualización adaptativa de histograma
Soporte multipágina:
- Los recibos de más de una página se detectan automáticamente (marcadores de salto de página, bordes doblados)
- Los recibos de varias páginas se unifican en un solo documento para su procesamiento
Información
Las fotos de recibos sin procesar son sorprendentemente variables. La iluminación oscura de restaurantes, los recibos arrugados de papel térmico de supermercados y los recibos con líneas de pliegue son comunes. El preprocesamiento normaliza estos a un formato coherente que ambos motores OCR manejan bien. Los controles de calidad en esta etapa evitan el 3–5 % de escaneos que de otro modo producirían resultados inutilizables.
Etapa 2: Extracción OCR — AWS Textract y Azure Document Intelligence
Este es el núcleo del pipeline. Yomio utiliza dos proveedores OCR:
AWS Textract:
- Proveedor principal para recibos estándar
- El mejor de su clase para extracción de texto impreso
- API de recibos (Expense) específicamente entrenada en diseños de recibos
- Detecta: nombre del comerciante, fecha de transacción, total, subtotal, impuesto, líneas de artículos, método de pago
Azure Document Intelligence (Form Recognizer):
- Proveedor secundario para recibos con diseños complejos
- Mejor para detectar estructuras de tablas dentro de los recibos
- Se utiliza como respaldo cuando las puntuaciones de confianza de Textract están por debajo del umbral
- Mejor detección de escritura a mano para recibos manuscritos
Lógica de selección de proveedor:
- Intento principal: AWS Textract
- Si la confianza de Textract < 70 % en campos clave: también ejecutar Azure Document Intelligence
- Comparar resultados — elegir el resultado de mayor confianza para cada campo
- Si ambos están por debajo del umbral: marcar el recibo para revisión manual
Esta arquitectura de doble proveedor significa que si un proveedor tiene un punto ciego para un formato de recibo específico (común con recibos no ingleses o diseños inusuales), el otro proveedor puede compensar.
Qué extrae cada proveedor
Ambos proveedores extraen campos similares, pero con diferentes fortalezas:
| Field | Textract Strength | Azure Doc Intel Strength |
|---|---|---|
| Merchant name | High (standard) | High (standard) |
| Transaction date | High | High |
| Total amount | Very high | Very high |
| Line items | High (simple layouts) | High (table layouts) |
| Tax amount | Medium | High |
| Discounts | Medium | High (item-level) |
| Currency detection | High | High |
| Handwriting | Low | Medium |
Etapa 3: Normalización — Haciendo los datos consistentes
La salida OCR bruta es precisa pero desordenada. "Starbucks Coffee #4521" y "Starbucks" deben reconocerse como el mismo comerciante. "05/08/2026" y "8 de mayo de 2026" deben ser la misma fecha. Esta etapa maneja esas transformaciones.
Normalización de comerciante:
- Coincidencia difusa de cadenas contra una base de datos de comerciantes (más de 50 000 comerciantes)
- Agrupación a nivel de marca: "Starbucks Coffee #4521" → "Starbucks"
- Identificación de cadena: franquicias locales asignadas a su marca matriz
- Aliases definidos por el usuario: si renombras un comerciante una vez, el sistema lo aprende
Normalización de fecha:
- Detecta el formato de fecha del recibo (EE. UU.: MM/DD/AAAA, UE: DD/MM/AAAA, ISO: AAAA-MM-DD)
- Resuelve ambigüedades usando contexto (un recibo de un comerciante del Reino Unido el 03/04/2026 → 3 de abril de 2026)
- Detección de zona horaria desde la ubicación del comerciante
Normalización de moneda:
- Detección de símbolos de moneda ($, €, £, ¥, etc.)
- Detección de código de tres letras (USD, EUR, GBP)
- Resolución de ambigüedad ($ podría ser USD, CAD, AUD, MXN — resuelto mediante la ubicación del comerciante)
Validación de monto:
- Verificaciones cruzadas: ¿subtotal + impuesto = total? Verificado contra la suma de líneas de artículos
- Detección de descuento: si la suma de líneas de artículos menos el total > umbral, se aplicó un descuento
- Detección de propina (recibos de restaurante): diferencia entre subtotal y total cuando existe una línea de propina
Etapa 4: Categorización — Etiquetado inteligente
Las líneas de artículos extraídas deben asignarse a categorías presupuestarias. Esto ocurre a través de un sistema de dos capas:
Capa 1: Reglas basadas en comerciante
- Los comerciantes conocidos tienen asignaciones de categoría predeterminadas
- "Kroger" → Comestibles (predeterminado), "Shell" → Transporte (predeterminado), "Netflix" → Entretenimiento (predeterminado)
- Los usuarios pueden anular por comerciante: "Quiero que Shell se clasifique como Transporte"
Capa 2: Categorización de IA a nivel de artículo
- Para comerciantes desconocidos o recibos de categorías mixtas (Target con comestibles y electrónica)
- Cada línea de artículo se categoriza por separado según el nombre del producto, el precio y los datos históricos
- Las categorías incluyen: Comestibles, Comidas, Transporte, Compras, Entretenimiento, Salud, Servicios públicos, Vivienda, Educación, Cuidado personal y más de 12 subcategorías
La puntuación de confianza de categorización determina si la asignación es automática o se sugiere para revisión. Con una confianza del 90 % o más, la categoría se aplica silenciosamente. Por debajo de eso, se resalta para confirmación del usuario.
Etapa 5: Enriquecimiento — Conexión con tu cuenta
La etapa final conecta el recibo procesado a tu cuenta de Yomio:
- Asignación de usuario — el recibo se vincula a tu cuenta (o grupo familiar si el uso compartido está habilitado)
- Actualización de inventario — las líneas de artículos que coinciden con artículos de inventario conocidos activan actualizaciones de cantidad (consulta nuestra inmersión en inventario)
- Detección de suscripciones — los comerciantes recurrentes con montos regulares se marcan como suscripciones potenciales
- Resolución de código de barras — los códigos de barras escaneados se comparan con Open Food Facts y bases de datos de productos para enriquecimiento
- Actualización de racha — el contador de racha diaria se incrementa
- Recompensa XP — el XP de escaneo se acredita en tu cuenta
Tiempo de procesamiento y escalabilidad
- Tiempo promedio de procesamiento: 2–6 segundos por recibo
- Rendimiento máximo: miles de recibos por minuto (escalado automático basado en Lambda)
- Almacenamiento: imágenes de recibos en S3, datos estructurados en PostgreSQL
- CDN: imágenes de recibos servidas a través de CDN para recuperación rápida
Consejo
Los propios proveedores OCR tardan de 1 a 3 segundos en procesar el recibo. El tiempo restante se divide entre el preprocesamiento (0,5 s), la normalización (0,3 s), la categorización (0,2 s) y el enriquecimiento (0,5 s). Los recibos de varias páginas tardan más debido al procesamiento página por página.
Puntos de referencia de precisión
Medimos continuamente la precisión del pipeline contra un conjunto de pruebas seleccionadas manualmente de 10 000 recibos:
| Metric | Current Accuracy |
|---|---|
| Total amount capture | 99,3 % |
| Line-item extraction | 94,7 % |
| Merchant detection | 98,1 % |
| Date detection | 99,5 % |
| Category assignment | 92,4 % |
| Currency detection | 99,7 % |
Donde todavía ocurren errores:
- Recibos manuscritos (30 % menos de precisión que los impresos)
- Papel térmico gravemente dañado (descolorido, enrollado, roto)
- Recibos con estructuras de descuento no estándar (BOGO, canjes de puntos de fidelidad)
- Términos y condiciones microimpresos (OCR los ignora intencionalmente)
Interactive review aid
Receipt review checklist
Select conditions that apply, then review the extracted fields against the receipt. No accuracy score is calculated.
Mejoras futuras
El pipeline se está mejorando activamente en tres áreas:
1. Reconocimiento de escritura a mano. La precisión actual de la escritura a mano es la mayor brecha. Estamos entrenando modelos personalizados en escritura a mano específica de recibos (montos de propinas, nombres de comerciantes escritos a mano, notas personales en recibos).
2. Cobertura de formato de recibos. Los recibos internacionales tienen diferentes diseños, estructuras impositivas e idiomas. Estamos ampliando los datos de entrenamiento de los proveedores para cubrir más formatos regionales.
3. Sugerencias de corrección en tiempo real. En lugar de requerir corrección manual después del escaneo, la próxima versión del pipeline sugerirá correcciones durante el flujo de escaneo, antes de que se finalice el recibo.
Prueba el pipeline OCR
Escanea cualquier recibo ahora mismo y ve el pipeline en acción. Del obturador a la entrada categorizada en menos de 10 segundos.
Escanear un recibo gratisPreguntas frecuentes
Lectura adicional
Escaneo de recibos vs. ingreso manual: 83 % de ahorro de tiempo
Cómo se compara la velocidad del pipeline con el ingreso manual — resultados de pruebas reales.
Cómo el AI Copilot de Yomio analiza tus gastos
Qué sucede después del pipeline — Yopilot usa los datos estructurados para análisis de IA.
De la despensa a la compra: Seguimiento de inventario y listas de compras
Cómo los datos del pipeline alimentan automáticamente la gestión de inventario.